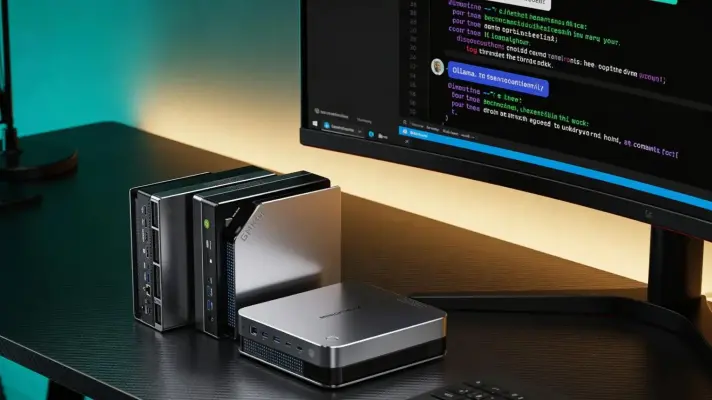
اجرای مدلهای زبانی بزرگ بهصورت محلی روی رایانه، دیگر فقط به کارتهای گرافیک قدرتمند و گرانقیمت محدود نیست. با پیشرفت پردازندههای گرافیکی مجتمع و افزایش حافظه قابلاستفاده برای هوش مصنوعی، حتی بعضی از رایانههای کوچک و پردازندههای قدیمیتر نیز میتوانند مدلهای زبانی را بدون وابستگی دائمی به سرویسهای ابری اجرا کنند. البته سرعت تولید پاسخ، میزان مصرف انرژی و اندازه مدلی که میتوان اجرا کرد، به سختافزار و نرمافزار مورد استفاده بستگی دارد.