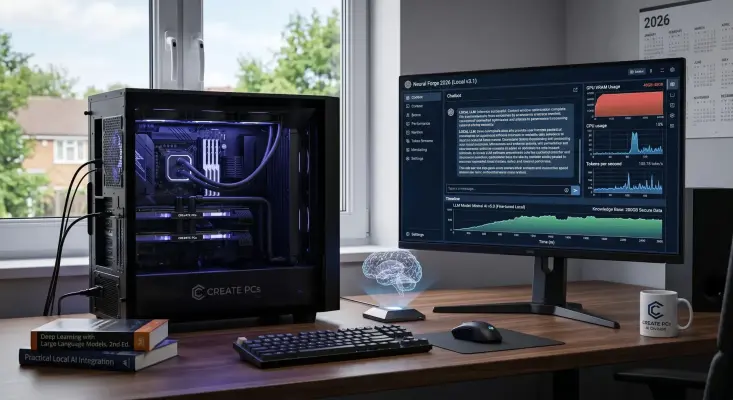
اجرای مدلهای زبانی بزرگ (LLM) روی کامپیوتر شخصی، بدون ارسال اطلاعات به سرویسهای آنلاین، به یکی از کاربردهای جذاب هوش مصنوعی محلی تبدیل شده است. با این حال، اجرای مدلهای بزرگ روی کارت گرافیکهای قدیمی یا اقتصادی همیشه ساده نیست؛ زیرا حافظه گرافیکی محدود میتواند اندازه مدل قابل اجرا و سرعت تولید پاسخ را محدود کند.
یکی از راهکارهای کاربردی برای عبور از این محدودیت، استفاده از معماری Mixture of Experts یا MoE است. این معماری به مدل اجازه میدهد برای پردازش هر ورودی فقط از بخشی از شبکه استفاده کند. در نتیجه، بعضی مدلهای MoE با وجود داشتن تعداد پارامترهای بسیار زیاد، میتوانند روی سیستمهایی با حافظه گرافیکی محدود نیز قابل اجرا باشند؛ البته سرعت نهایی به مدل، میزان فشردهسازی، حافظه رم و تنظیمات نرمافزار بستگی دارد.