Ollama

اجرای مدل‌های هوش مصنوعی بزرگ روی کارت گرافیک ضعیف با معماری MoE

اجرای مدل‌های زبانی بزرگ (LLM) روی کامپیوتر شخصی، بدون ارسال اطلاعات به سرویس‌های آنلاین، به یکی از کاربردهای جذاب هوش مصنوعی محلی تبدیل شده است. با این حال، اجرای مدل‌های بزرگ روی کارت گرافیک‌های قدیمی یا اقتصادی همیشه ساده نیست؛ زیرا حافظه گرافیکی محدود می‌تواند اندازه مدل قابل اجرا و سرعت تولید پاسخ را محدود کند.

یکی از راهکارهای کاربردی برای عبور از این محدودیت، استفاده از معماری Mixture of Experts یا MoE است. این معماری به مدل اجازه می‌دهد برای پردازش هر ورودی فقط از بخشی از شبکه استفاده کند. در نتیجه، بعضی مدل‌های MoE با وجود داشتن تعداد پارامترهای بسیار زیاد، می‌توانند روی سیستم‌هایی با حافظه گرافیکی محدود نیز قابل اجرا باشند؛ البته سرعت نهایی به مدل، میزان فشرده‌سازی، حافظه رم و تنظیمات نرم‌افزار بستگی دارد.

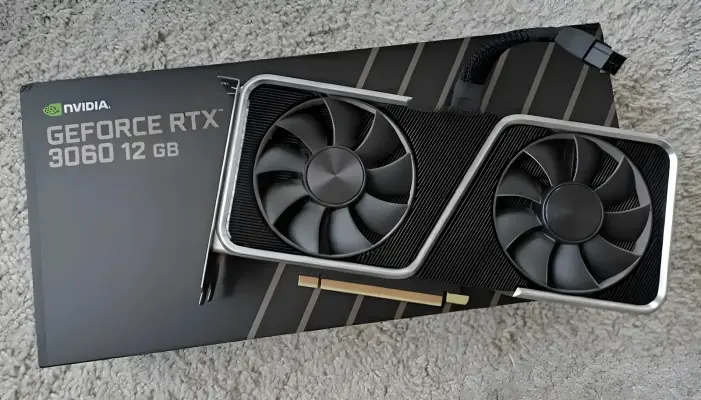
چرا کارت گرافیک RTX 3060 با حافظه ۱۲ گیگابایتی دوباره ارزشمند شده است؟

کارت گرافیک RTX 3060 با حافظه ۱۲ گیگابایتی در زمان عرضه در سال ۲۰۲۱، یکی از گزینه‌های مناسب برای گیمرهایی بود که به دنبال سخت‌افزاری مقرون‌به‌صرفه بودند. این کارت هرگز سریع‌ترین عضو خانواده Ampere نبود و عملکرد آن در رهگیری پرتو نیز چندان چشمگیر به نظر نمی‌رسید؛ اما چند سال بعد، شرایط بازار سخت‌افزار تغییر کرده و همین مدل قدیمی دوباره اهمیت پیدا کرده است.

نکته جالب این است که سخت‌افزار اصلی RTX 3060 تغییر نکرده، اما نیازهای جدید بازار باعث شده‌اند حافظه گرافیکی ۱۲ گیگابایتی آن ارزش بیشتری پیدا کند. کمبود حافظه در بازار کارت‌های گرافیک و افزایش تقاضا برای اجرای مدل‌های هوش مصنوعی به‌صورت محلی، از عواملی هستند که جایگاه این کارت را تغییر داده‌اند.

کاهش مصرف RAM و VRAM در Ollama؛ تنظیم Context و KV Cache

وقتی یک مدل هوش مصنوعی را با Ollama اجرا می‌کنید، مقدار حافظه موردنیاز فقط به حجم فایل مدل بستگی ندارد. اندازه پنجره Context نیز می‌تواند مقدار قابل‌توجهی از RAM یا VRAM را مصرف کند، حتی اگر در عمل از تمام ظرفیت آن استفاده نکنید. بنابراین اگر معمولاً با مکالمه‌های کوتاه چند هزار توکنی کار می‌کنید، کاهش Context می‌تواند یکی از ساده‌ترین روش‌ها برای آزاد کردن حافظه و جلوگیری از کندشدن سیستم باشد.

اجرای هوش مصنوعی روی کامپیوتر؛ معرفی Qwen3.8-27B و Ollama برای پردازش محلی

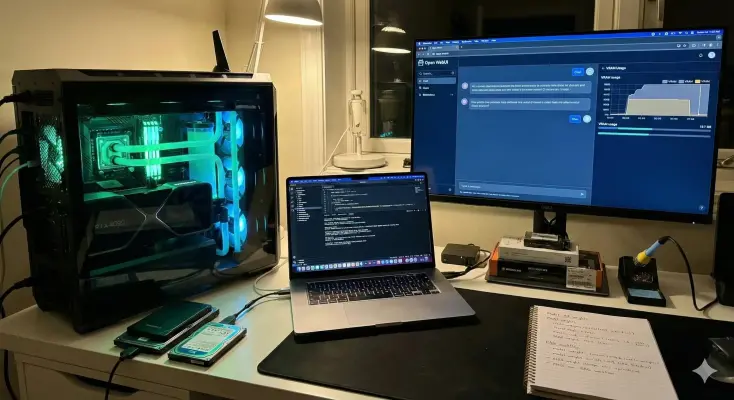
وقتی فایل‌های حساس را برای پردازش به سرویس‌های هوش مصنوعی ابری می‌فرستید، اطلاعات شما از کامپیوتر خارج شده و روی زیرساخت یک شرکت دیگر پردازش می‌شود. برای اسناد پزشکی، قراردادها، اطلاعات مالی، کدهای اختصاصی و فایل‌های شخصی، اجرای مدل هوش مصنوعی روی کامپیوتر می‌تواند رویکرد متفاوتی باشد؛ چون در حالت کاملاً محلی، فایل برای پردازش به سرویس ابری ارسال نمی‌شود. ابزارهایی مانند Ollama نیز اجرای مدل‌های محلی را روی دستگاه کاربر پشتیبانی می‌کنند.

البته اجرای محلی به معنی حذف تمام خطرات امنیتی نیست. اگر خود کامپیوتر آلوده باشد یا مدل و نرم‌افزار اجراکننده از منبع نامطمئن دریافت شده باشند، اطلاعات همچنان در معرض خطر قرار می‌گیرند. مزیت اصلی این روش این است که برای پردازش محلی، اطلاعات نیازی به عبور از سرویس هوش مصنوعی ابری ندارد.

چرا Ollama کند است؟ افزایش سرعت مدل‌های هوش مصنوعی محلی با کاهش مصرف VRAM

مدل‌های هوش مصنوعی محلی به دلیل اجرای مستقیم روی کامپیوتر می‌توانند بدون ارسال داده به سرویس ابری کار کنند و برای کارهایی مثل تولید متن، کدنویسی و خلاصه‌سازی گزینه‌ای کاربردی باشند. با این حال سرعت اجرای آن‌ها فقط به قدرت پردازنده یا تعداد پارامترهای مدل بستگی ندارد. مقدار VRAM کارت گرافیک و تنظیمات مربوط به Context نیز تأثیر زیادی بر سرعت تولید پاسخ دارند.

اگر مدل نتواند به‌طور کامل در حافظه کارت گرافیک قرار بگیرد و بخشی از پردازش به رم سیستم منتقل شود، سرعت تولید توکن می‌تواند به شکل محسوسی کاهش پیدا کند. در Ollama نیز افزایش Context باعث مصرف بیشتر حافظه می‌شود و به همین دلیل انتخاب یک مقدار مناسب برای num_ctx یکی از تنظیمات مهم برای سیستم‌های دارای VRAM محدود است.

آخرین دیدگاه‌ها
۲۰۰ دیدگاه و پاسخ آخر