وقتی فایلهای حساس را برای پردازش به سرویسهای هوش مصنوعی ابری میفرستید، اطلاعات شما از کامپیوتر خارج شده و روی زیرساخت یک شرکت دیگر پردازش میشود. برای اسناد پزشکی، قراردادها، اطلاعات مالی، کدهای اختصاصی و فایلهای شخصی، اجرای مدل هوش مصنوعی روی کامپیوتر میتواند رویکرد متفاوتی باشد؛ چون در حالت کاملاً محلی، فایل برای پردازش به سرویس ابری ارسال نمیشود. ابزارهایی مانند Ollama نیز اجرای مدلهای محلی را روی دستگاه کاربر پشتیبانی میکنند.
البته اجرای محلی به معنی حذف تمام خطرات امنیتی نیست. اگر خود کامپیوتر آلوده باشد یا مدل و نرمافزار اجراکننده از منبع نامطمئن دریافت شده باشند، اطلاعات همچنان در معرض خطر قرار میگیرند. مزیت اصلی این روش این است که برای پردازش محلی، اطلاعات نیازی به عبور از سرویس هوش مصنوعی ابری ندارد.
چرا اجرای هوش مصنوعی به صورت محلی برای فایلهای حساس اهمیت دارد؟
سرویسهای ابری هوش مصنوعی میتوانند بسیار قدرتمند باشند، اما هنگام ارسال یک فایل باید به سیاستهای نگهداری اطلاعات، حریم خصوصی و نحوه پردازش دادهها توجه کرد. سیاستهای سرویسها نیز ممکن است در طول زمان تغییر کنند. به همین دلیل برای اطلاعاتی که نمیخواهید از کامپیوترتان خارج شوند، اجرای مدل محلی یک گزینه قابل بررسی است.
در مدل محلی، وزنهای مدل و فرایند پردازش روی کامپیوتر شما قرار دارند. ابزارهایی مانند Ollama نیز صراحتاً اعلام میکنند که هنگام اجرای مدل محلی، درخواستها و دادههایی که روی دستگاه پردازش میشوند برای سرویس ابری ارسال نمیشوند.
این روش برای بررسی قراردادها، اسناد داخلی، فایلهای متنی و دادههایی که ماهیت خصوصی دارند کاربرد زیادی دارد. حتی میتوان کامپیوتر محلی را برای پردازش آفلاین تنظیم کرد تا در زمان تحلیل اسناد ارتباط شبکهای نداشته باشد؛ البته این سطح از جداسازی به تنظیمات امنیتی سیستم و شبکه نیز وابسته است.
Qwen3.8-27B برای اجرای هوش مصنوعی روی کامپیوتر
یکی از مدلهای قابل توجه در سال ۲۰۲۶، Qwen3.8-27B است. این مدل در قالب اصلی حدود ۲۸ میلیارد پارامتر دارد و نسخههای مختلف آن برای اجرا با روشهای متفاوت در دسترس هستند. مدل رسمی Qwen در Hugging Face نیز قابلیت پردازش تصویر را نشان میدهد و برای استفاده با ابزارهایی مانند Transformers و vLLM ارائه شده است.
یکی از ویژگیهای مهم Qwen3.8-27B پشتیبانی بومی از ورودی تصویری است. بنابراین مدل میتواند علاوه بر متن، تصاویر و اسناد تصویری را نیز پردازش کند. این ویژگی برای تحلیل اسکن اسناد یا تصاویر میتواند کاربردی باشد و همیشه به یک ابزار OCR جداگانه نیاز نیست.
البته عدد ۲۷ میلیارد پارامتر به این معنی نیست که هر کامپیوتری میتواند مدل را با سرعت بالا اجرا کند. برای کاهش مصرف حافظه معمولاً از Quantization استفاده میشود. نسخههای ۴ بیتی میتوانند بخش قابل توجهی از مدل را با حافظه کمتری اجرا کنند و در سیستمهایی که VRAM کافی ندارند، بخشی از مدل به RAM منتقل میشود.
برای اجرای مدل 27B به چه سختافزاری نیاز داریم؟
برای مدلهای محلی بزرگ، ظرفیت VRAM کارت گرافیک اهمیت زیادی دارد. در بسیاری از سیستمها داشتن VRAM بیشتر امکان اجرای مدل بزرگتر یا استفاده از Quantization با کیفیت بالاتر را فراهم میکند. منابع تخصصی اجرای LLM نیز تأکید میکنند که هنگام انتخاب سختافزار برای هوش مصنوعی محلی، VRAM یکی از مهمترین محدودیتها است.
یک کامپیوتر گیمینگ با ۳۲ گیگابایت RAM و کارت گرافیک ۱۲ یا ۱۶ گیگابایتی میتواند برای اجرای نسخه ۴ بیتی یک مدل 27B مناسب باشد، اما ممکن است تمام مدل در VRAM جا نشود. در این حالت بخشی از پردازش به RAM سیستم منتقل میشود و سرعت تولید پاسخ کاهش پیدا میکند.
کارت گرافیک RTX 3090 با ۲۴ گیگابایت VRAM همچنان برای اجرای مدلهای محلی بزرگ جذاب است. ظرفیت بالای VRAM این کارت باعث میشود برخی مدلهای بزرگتر بدون نیاز به تقسیم گسترده بین VRAM و RAM اجرا شوند. البته هنگام خرید کارت دستدوم باید سلامت کارت و مقدار واقعی VRAM آن بررسی شود.
در چنین استفادهای سرعت پردازنده نیز مهم است اما کمبود VRAM معمولاً محدودیت جدیتری ایجاد میکند. اگر مدل بهطور کامل در حافظه کارت گرافیک جا نشود، انتقال داده بین VRAM و RAM میتواند سرعت تولید پاسخ را به میزان محسوسی کاهش دهد.
اجرای Qwen3.8-27B برای تحلیل اسناد چه کاربردی دارد؟
مدلهای محلی 27B میتوانند برای استخراج اطلاعات از قراردادها، خلاصهسازی اسناد، بررسی متن، پیدا کردن بندهای خاص و تحلیل ساختار یک فایل استفاده شوند. Qwen3.8-27B نیز به دلیل پشتیبانی از ورودی تصویری میتواند برای اسناد اسکنشده و تصاویر در کنار متن کاربرد داشته باشد.
با این حال، نباید توانایی استخراج اطلاعات را با دانش عمومی یا تخصصی یکسان دانست. یک مدل محلی ممکن است یک مقدار مشخص از یک سند را بهخوبی پیدا کند اما در تفسیر تخصصی همان اطلاعات، بهخصوص در حوزههایی مانند پزشکی یا حقوق، عملکرد متفاوتی داشته باشد.
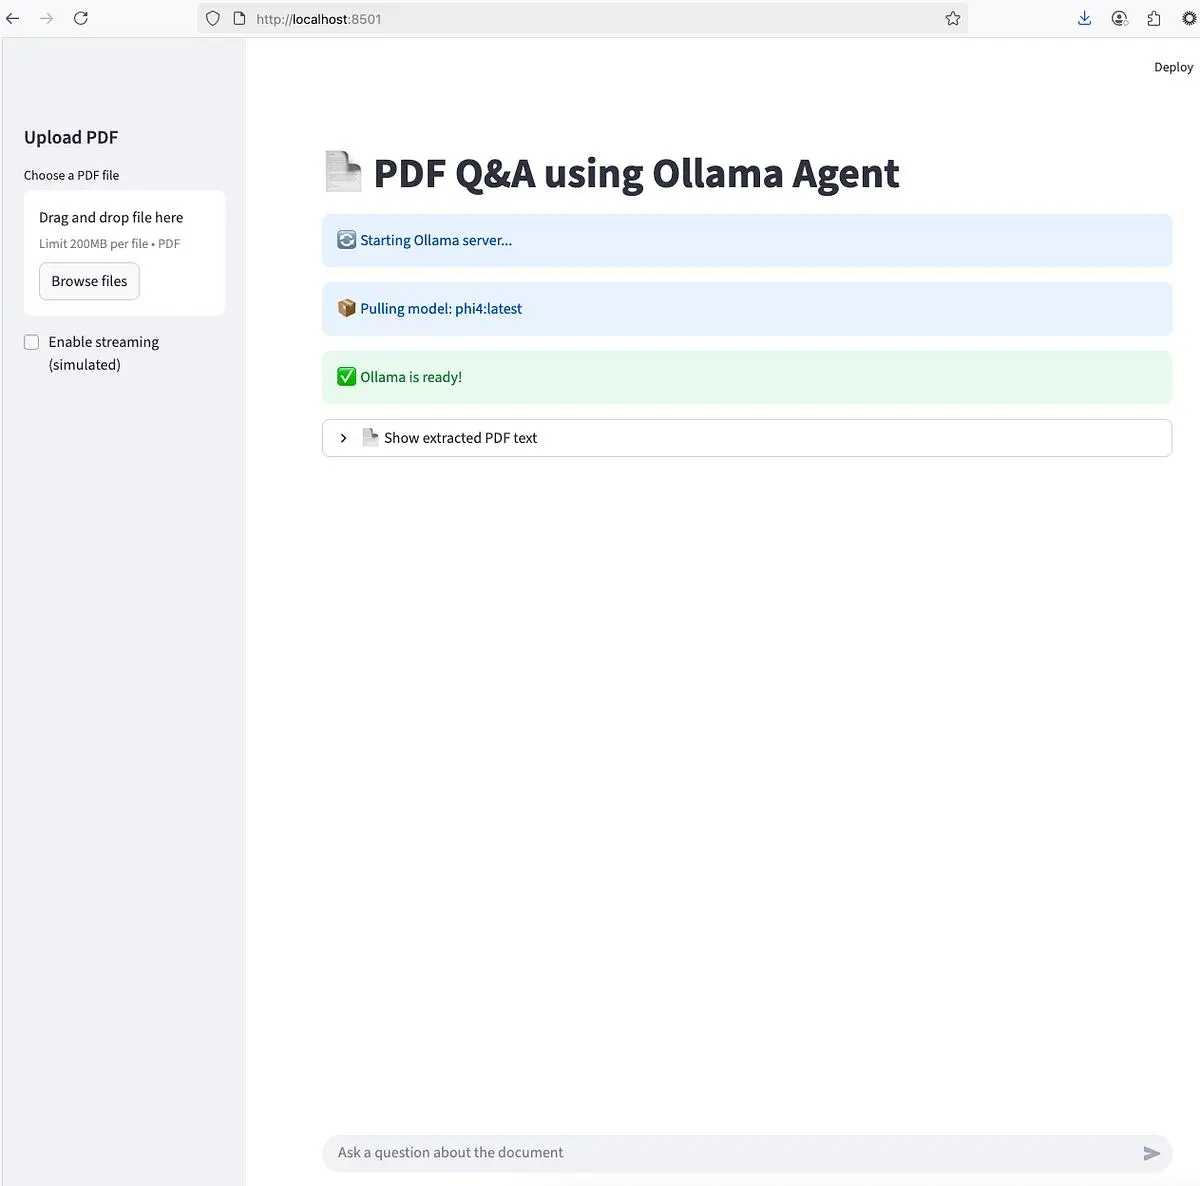
به عنوان مثال، مدل میتواند مقدار مشخصی را از یک گزارش پزشکی استخراج کند یا بند خاصی از قرارداد را پیدا کند اما نتیجهگیری پزشکی یا حقوقی از همان اطلاعات نیازمند بررسی توسط متخصص است. بنابراین بهتر است هوش مصنوعی محلی را ابزار تحلیل و استخراج اطلاعات بدانیم و نه جایگزین متخصص.
Ollama و ابزارهای اجرای مدل محلی
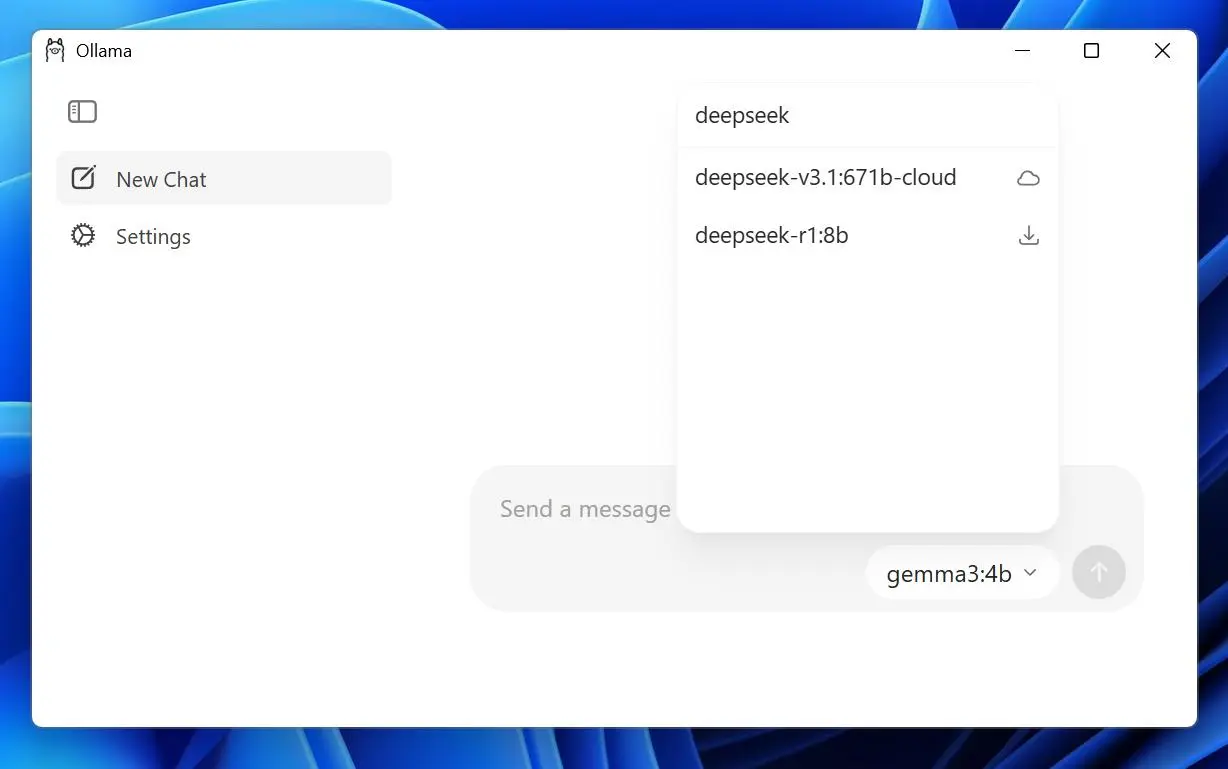
Ollama یکی از ابزارهایی است که اجرای مدلهای هوش مصنوعی روی کامپیوتر را سادهتر میکند. این ابزار امکان اجرای مدلهای مختلف را روی سختافزار محلی فراهم میکند و در صورت استفاده از مدل محلی، داده پردازششده روی همان دستگاه باقی میماند.
برای کاربران مبتدی، ابزارهایی مانند Ollama میتوانند شروع کار با مدلهای محلی را سادهتر کنند. در عین حال گزینههای دیگری مانند LM Studio و اجرای مستقیم مدل با ابزارهایی مانند llama.cpp یا vLLM نیز وجود دارند. انتخاب ابزار به سیستمعامل، کارت گرافیک، نوع مدل و میزان کنترل مورد نیاز کاربر بستگی دارد.
یک نکته مهم این است که محلی بودن مدل را با خصوصی بودن کامل کل سیستم اشتباه نگیرید. اگر نرمافزار اجراکننده، افزونهها یا سایر برنامههای نصبشده روی سیستم امکان ارسال اطلاعات به اینترنت داشته باشند، باید رفتار آنها نیز بررسی شود. برای اطلاعات بسیار حساس، اجرای مدل در محیط محدودشده یا حتی بدون دسترسی شبکه میتواند سطح حفاظت را بیشتر کند.
در نتیجه، اگر کامپیوتر شما حداقل حدود ۳۲ گیگابایت RAM و کارت گرافیکی با ۱۲ تا ۱۶ گیگابایت VRAM دارد، اجرای مدلهای محلی نسبتاً بزرگ امکانپذیر است. برای مدلهای 27B، کارتهایی با VRAM بیشتر شرایط مناسبتری فراهم میکنند. Qwen3.8-27B نیز به دلیل پشتیبانی از متن و تصویر، یکی از مدلهایی است که میتوان برای تحلیل محلی اسناد بررسی کرد.
با این حال، مدل محلی الزاماً از مدلهای ابری قدرتمندتر نیست. سرویسهای ابری همچنان میتوانند از مدلهای بزرگتر و زیرساخت محاسباتی قدرتمندتری استفاده کنند. مزیت اصلی اجرای محلی برای بسیاری از کاربران، کنترل بیشتر روی داده، امکان پردازش آفلاین و کاهش وابستگی به سرویسهای ابری است.
گیم پلنت