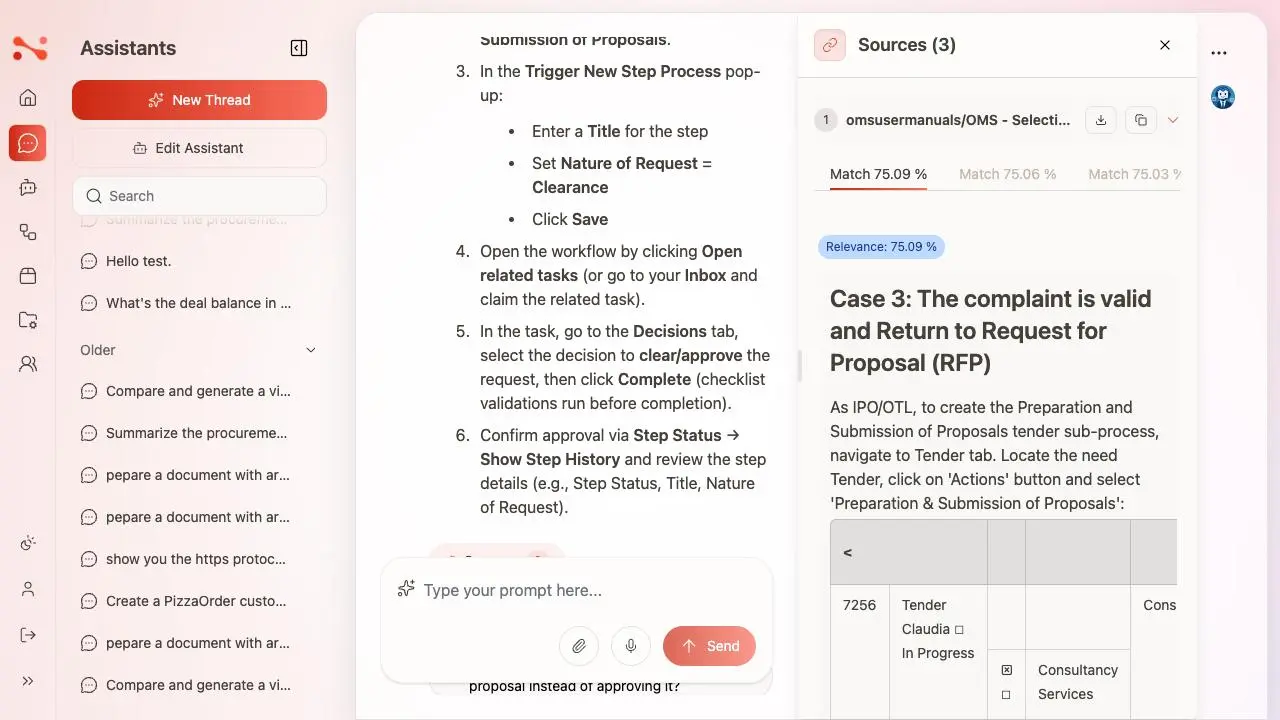
امروزه بسیاری از دستیارهای هوش مصنوعی امکان بارگذاری فایل و پرسش درباره اسناد را فراهم کردهاند. مشکل از جایی شروع میشود که فایل موردنظر حاوی اطلاعات بانکی، قراردادها، اسناد حقوقی، مدارک بیمه یا اطلاعات پزشکی باشد. در چنین شرایطی ارسال فایل به یک سرویس ابری ممکن است با الزامات حریم خصوصی یا سیاستهای شخصی کاربر سازگار نباشد.
هوش مصنوعی محلی میتواند بخشی از این مشکل را حل کند. در این روش مدل زبانی روی خود گوشی اجرا میشود و فایل نیز به جای آپلود روی سرور، در حافظه دستگاه پردازش میشود. البته «محلی بودن» بهتنهایی کافی نیست و باید بررسی کرد که برنامه دقیقاً برای جستوجوی اسناد از چه مسیرهایی استفاده میکند و آیا قابلیتهای آنلاین اختیاری فعال هستند یا نه. مستندات فعلی Noema نیز میان قابلیتهای کاملاً محلی و امکاناتی مانند جستوجوی وب یا مدلهای راه دور تفاوت مشخصی قائل میشود.
چرا هوش مصنوعی محلی روی گوشی برای فایلهای حساس اهمیت دارد؟
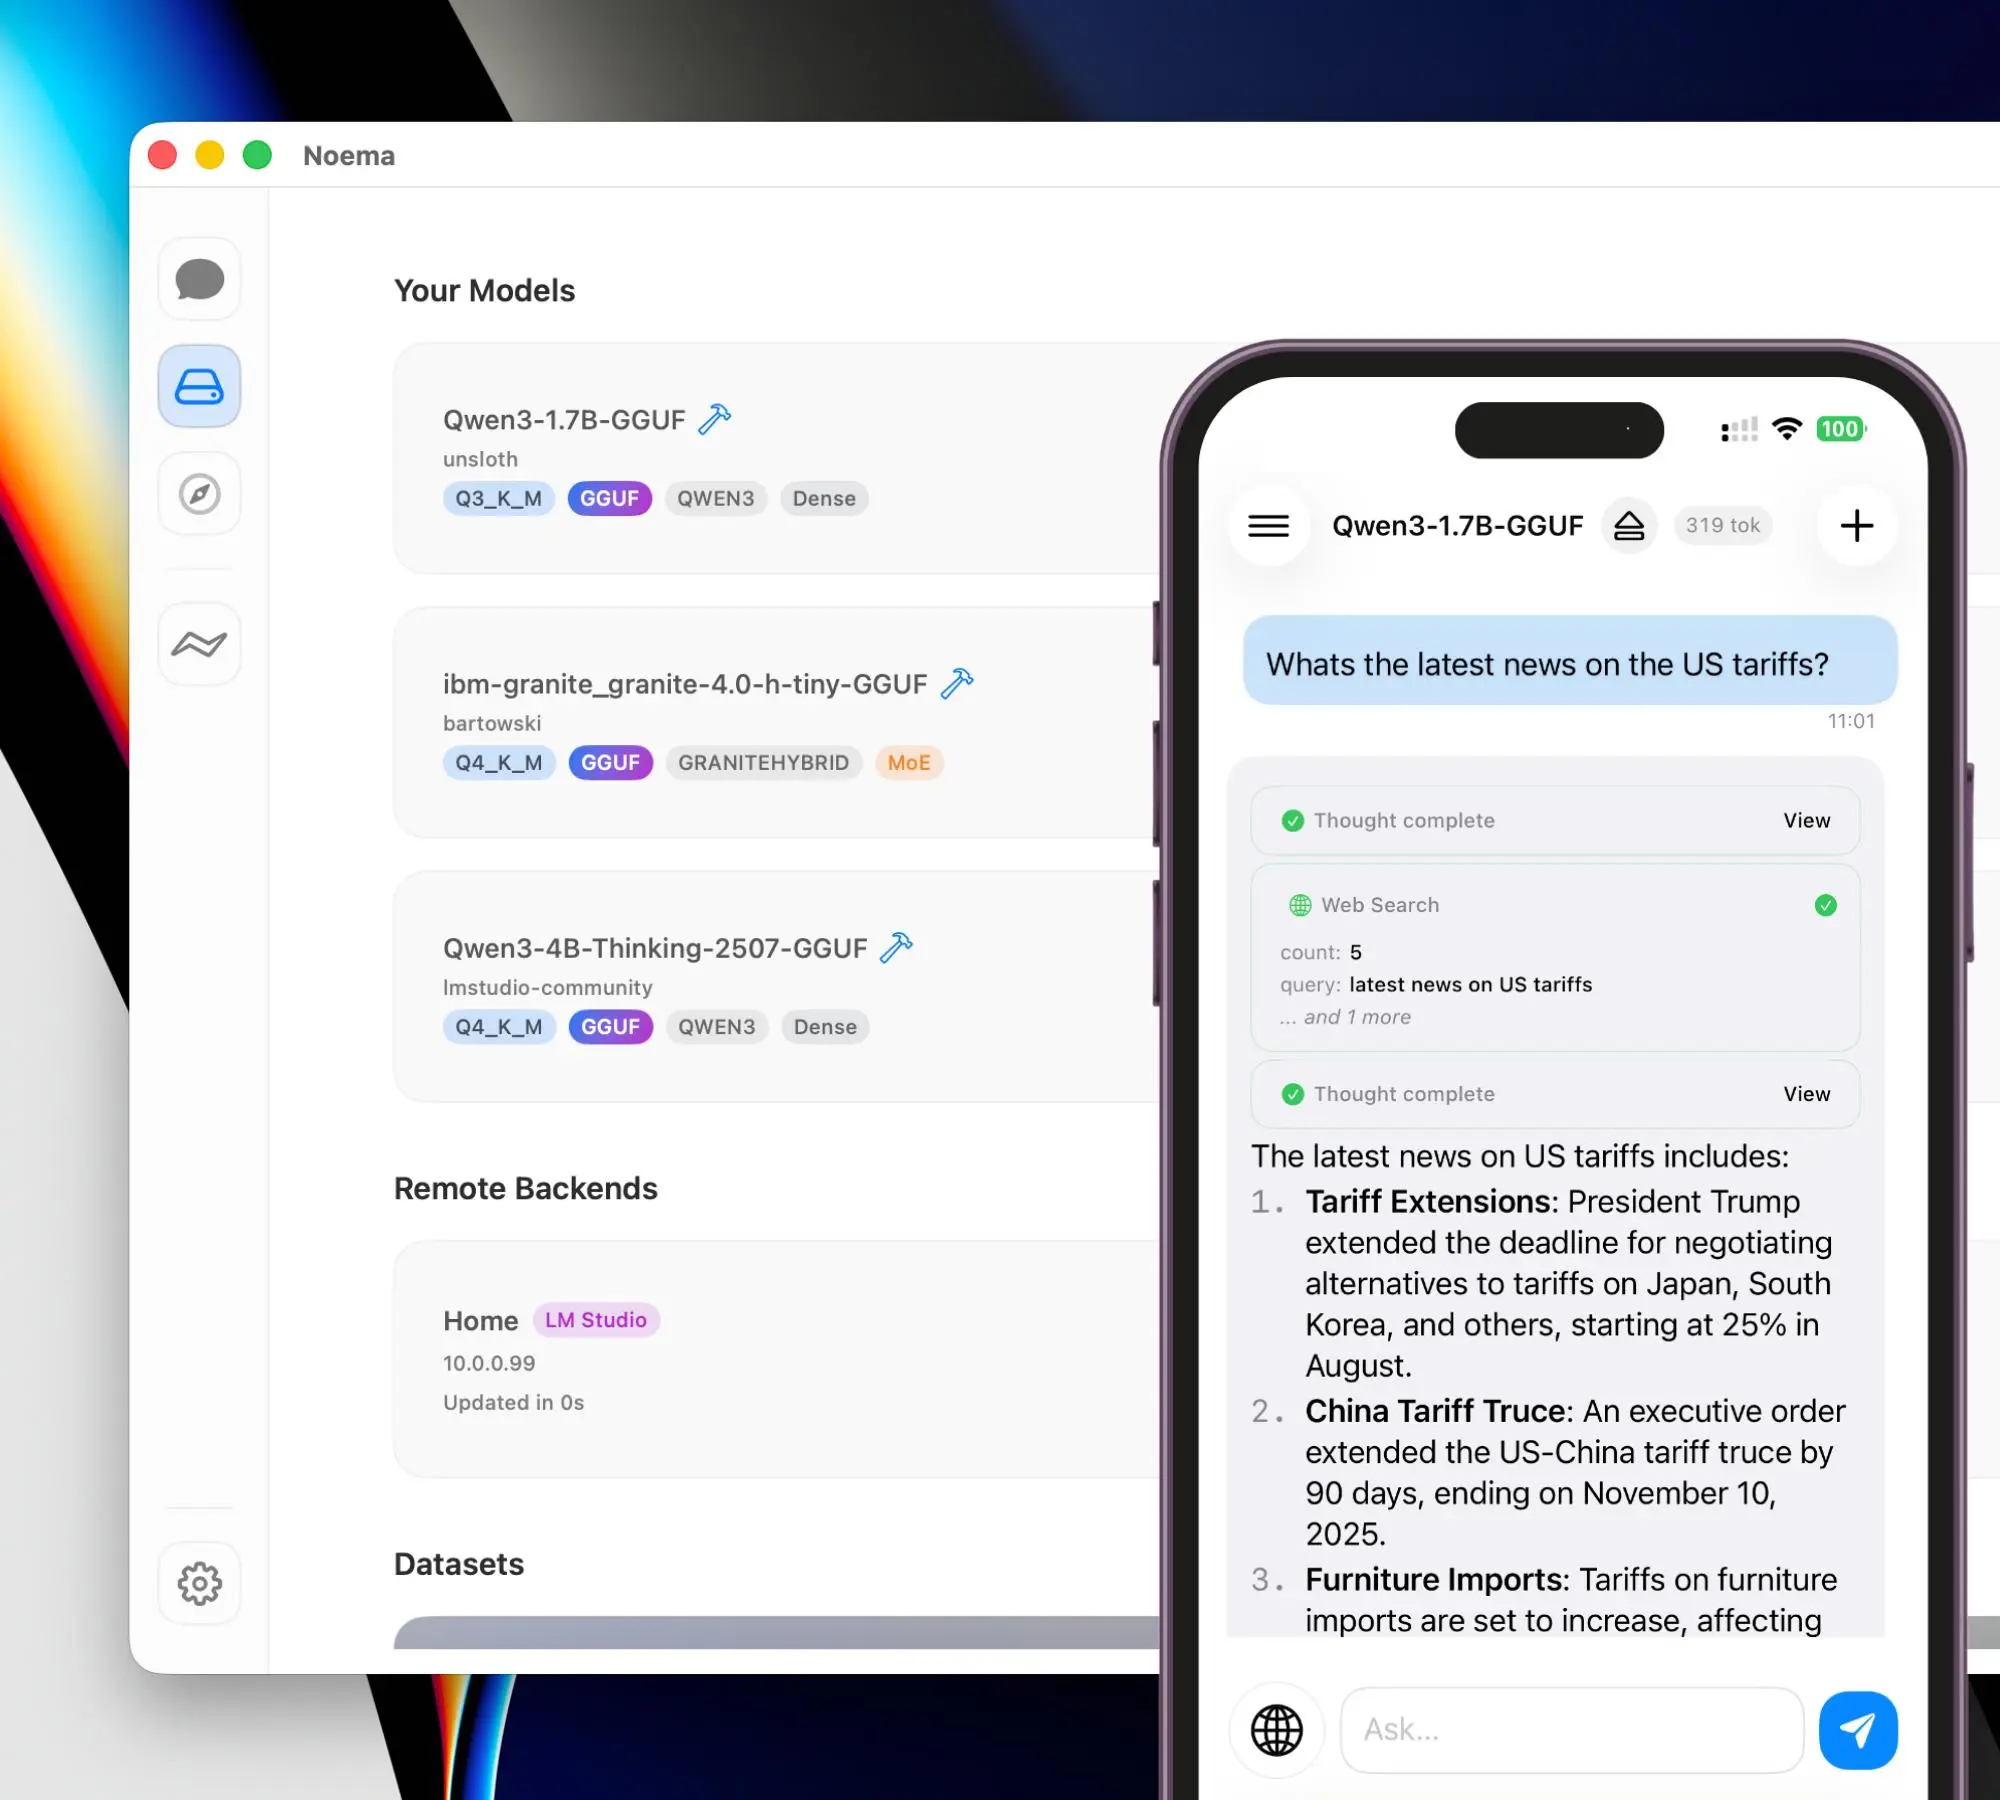
اجرای یک مدل زبانی کوچک روی گوشی دیگر یک قابلیت عجیب و آزمایشی نیست. برنامههایی مانند Noema میتوانند مدلهای سازگار را مستقیماً روی iPhone و iPad اجرا کنند و در کنار گفتوگوی معمولی امکان جستوجو در فایلهای شخصی را نیز ارائه میدهند. نسخه فعلی Noema برای دستگاههای اپل عرضه شده و از iPhone و iPad و Mac و Apple Vision پشتیبانی میکند.
تفاوت اصلی زمانی مشخص میشود که بخواهید یک فایل واقعی را وارد جریان کاری هوش مصنوعی کنید. در یک چتبات ابری معمولاً فایل به زیرساخت سرویس ارسال میشود تا پردازش شود. اما در یک جریان کاری محلی میتوان فایل را روی گوشی نگه داشت و عملیات استخراج متن و جستوجوی محتوای آن را روی همان دستگاه انجام داد.
این موضوع برای اسنادی مانند صورتحساب بانکی و قرارداد و گزارش بیمه یا فایلهای شخصی اهمیت بیشتری دارد. با این حال حتی در یک برنامه محلی هم نباید تصور کرد که تمام قابلیتها همیشه بدون شبکه کار میکنند. به عنوان مثال Noema قابلیتهایی مانند Web Search و مدلهای راه دور دارد که در صورت استفاده میتوانند ارتباط شبکهای ایجاد کنند.
چرا اجرای مدل روی گوشی بهتنهایی برای کار با اسناد کافی نیست؟
چت معمولی با یک مدل محلی نسبتاً ساده است. شما مدل را بارگذاری میکنید و متن را به آن میدهید. اما یک فایل PDF چندصدصفحهای را نمیتوان همیشه به شکل کامل وارد پنجره متن مدل کرد.
اینجاست که RAG یا تولید تقویتشده با بازیابی اهمیت پیدا میکند. برنامه ابتدا محتوای سند را استخراج و به بخشهای کوچکتر تقسیم میکند. سپس این بخشها به بردارهای معنایی تبدیل و در یک نمایه جستوجو ذخیره میشوند. هنگام پرسیدن سؤال نیز برنامه بخشهای مرتبط را پیدا میکند و فقط همان قسمتها را در اختیار مدل قرار میدهد.
به همین دلیل RAG برای گوشی اهمیت زیادی دارد. علاوه بر مدل زبانی باید پردازش اسناد و مدل embedding و نمایه جستوجو نیز روی منابع محدود دستگاه مدیریت شوند. Noema در مستندات فعلی خود نیز تأکید میکند که برای جستوجوی اسناد یک embedding model جداگانه موردنیاز است و پس از استخراج و قطعهبندی محتوا باید ساخت نمایه و embedding نیز کامل شود.
چگونه با Noema روی iPhone و iPad با فایلهای PDF چت کنیم؟
Noema اکنون امکان افزودن فایلهایی مانند PDF و EPUB و Markdown و فایل متنی را دارد و میتواند محتوای آنها را برای بازیابی محلی نمایهسازی کند. در نسخههای جدیدتر حتی امکان پیوست مستقیم اسناد به گفتوگو در iPhone و iPad اضافه شده است.
برای شروع باید ابتدا یک مدل زبانی سازگار را روی دستگاه دریافت کنید. مستندات فعلی Noema مدل Qwen 3.5 2B GGUF را به عنوان گزینه شروع پیشنهاد میکنند. مدلهای بزرگتر به حافظه بیشتری نیاز دارند و انتخاب مدل مناسب به رم دستگاه و نوع کوانتایز و اندازه Context بستگی دارد.
برای استفاده از قابلیت جستوجوی اسناد نیز باید embedding model را نصب کنید. این مدل با مدل زبانی اصلی تفاوت دارد و برای تبدیل بخشهای مختلف سند به نمایش معنایی و پیدا کردن قسمتهای مرتبط استفاده میشود.
مسیر کلی در برنامه برای آمادهسازی مدل:
Explore → Models → انتخاب مدل → Download
بعد از آماده شدن مدل میتوانید فایل را از Files انتخاب و وارد گفتوگو یا مجموعه اسناد کنید. پس از اتمام استخراج و نمایهسازی محتوا امکان پرسیدن سؤال درباره سند فراهم میشود.
RAG در Noema چگونه پاسخ سؤال درباره سند را پیدا میکند؟
فرض کنید یک PDF شامل چندین صفحه اطلاعات مالی دارید و از برنامه میپرسید «مبلغ پرداختی در ماه آخر چقدر بوده است؟». برنامه لازم نیست کل سند را به مدل بدهد. ابتدا سؤال را به یک نمایش معنایی تبدیل میکند و سپس در نمایه سند به دنبال بخشهای مرتبط میگردد.
بخشهای پیدا شده وارد Context مدل میشوند و مدل پاسخ خود را بر اساس همان اطلاعات تولید میکند. این روش هم مصرف Context را کاهش میدهد و هم اجازه میدهد مدلهای کوچکتر با اسناد بزرگتر کار کنند.
مستندات Noema همچنین تأکید میکنند که اطلاعات بازیابیشده ممکن است همراه با اطلاعات منبع در اختیار مدل قرار گیرد اما برای کارهای حساس نباید صرفاً به پاسخ تولیدشده اعتماد کرد و بهتر است متن اصلی منبع نیز بررسی شود.
در نسخههای جدید Noema قابلیت کار با PDF نیز توسعه پیدا کرده و طبق اطلاعات فعلی App Store میتوان PDF و EPUB و فایلهای متنی را مستقیماً از Files به برنامه اضافه کرد.
تنظیمات مهم برای اجرای سریعتر هوش مصنوعی محلی
بعد از نصب مدل بهتر است قبل از وارد کردن تعداد زیادی سند، اندازه Context و میزان استفاده از GPU و تعداد Threadها را بررسی کنید. افزایش بیش از حد Context میتواند مصرف حافظه را بالا ببرد و اجرای مدل را روی گوشی کندتر کند.
انتخاب مدل کوچکتر نیز همیشه به معنی تجربه ضعیف نیست. برای خلاصهسازی و پرسش از اسناد مشخص، یک مدل کوانتایز شده کوچک میتواند نسبت به یک مدل بزرگتر که بهسختی روی گوشی اجرا میشود، کاربردیتر باشد. خود Noema نیز برای انتخاب مدل ابزارهای بررسی سازگاری حافظه ارائه میکند.
در صورت استفاده طولانی از مدلهای محلی باید مصرف باتری و گرمای دستگاه را نیز در نظر گرفت. سرعت اجرای مدل به مدل انتخابی و سختافزار و Context و وضعیت حرارتی دستگاه وابسته است و نمیتوان یک سرعت ثابت برای تمام گوشیها تعیین کرد.
فعال کردن حالت آفلاین برای کاهش ارتباطات شبکهای
اگر هدف اصلی استفاده کاملاً محلی است، بررسی قابلیت Off-grid Mode اهمیت زیادی دارد. Noema در مستندات فعلی اعلام میکند که این حالت ارتباطات HTTP و HTTPS خارجی را که توسط خود برنامه ایجاد میشوند مسدود میکند. با این حال قابلیتهایی که ذاتاً به شبکه نیاز دارند مانند Web Search و مدلهای راه دور در این حالت قابل استفاده معمول نخواهند بود.
مسیر تنظیمات:
Settings → Off-grid Mode
این حالت را بهتر است زمانی فعال کنید که مدل و فایلهای موردنیاز را از قبل دریافت کرده باشید. در غیر این صورت دانلود مدل یا استفاده از سرویسهایی که به اینترنت نیاز دارند انجام نخواهد شد.
نکته مهم این است که فعال کردن حالت آفلاین نباید با یک تضمین مطلق درباره امنیت تمام دادههای دستگاه اشتباه گرفته شود. تنظیمات پشتیبانگیری سیستمعامل و سرویسهای دیگری که روی دستگاه فعال هستند همچنان میتوانند روی حریم خصوصی فایلها اثر بگذارند.
کاربران اندروید چه گزینهای برای RAG محلی دارند؟
Noema در حال حاضر برای دستگاههای اپل عرضه میشود و گزینهای برای اندروید نیست. برای اندروید میتوان سراغ برنامههایی رفت که RAG محلی را به صورت مستقیم ارائه میکنند. یکی از گزینههای فعلی LocalRAG است که روی iPhone و iPad و Android در دسترس است.
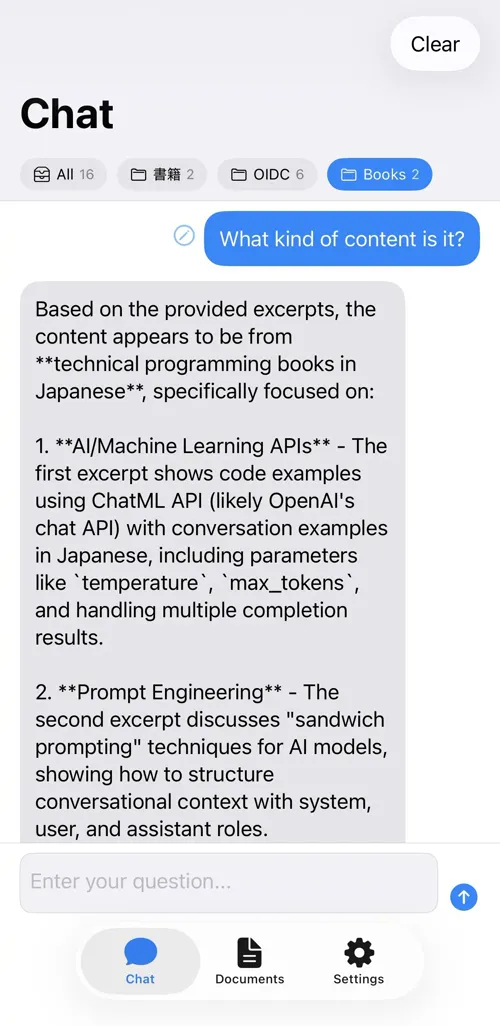
LocalRAG از فرمتهای متنوعی مانند PDF و EPUB و DOCX و XLSX و PPTX و TXT و Markdown و فایلهای تصویری پشتیبانی میکند و استخراج متن و نمایهسازی و بازیابی اسناد را روی دستگاه انجام میدهد. در حالت Local AI نیز تولید پاسخ میتواند روی خود دستگاه انجام شود و پس از آمادهسازی مدل امکان استفاده بدون اینترنت وجود دارد.
مسیر کلی کار در چنین برنامههایی نیز مشابه است: فایل را وارد میکنید و اجازه میدهید متن استخراج و نمایه ساخته شود و سپس مدل محلی را برای پاسخگویی انتخاب میکنید. این ساختار برای PDFهای طولانی و مجموعهای از اسناد کاربرد بیشتری نسبت به کپی و پیست کردن دستی متن دارد.
محدودیتهای هوش مصنوعی محلی برای اسناد
مهمترین محدودیت، منابع سختافزاری گوشی است. مدلهای بزرگتر به رم بیشتری نیاز دارند و زمان پردازش آنها نیز میتواند بیشتر باشد. علاوه بر خود مدل باید فضای کافی برای مدل embedding و نمایه اسناد و فایلهای موقت نیز در نظر گرفته شود.
محدودیت بعدی کیفیت پاسخ است. RAG تضمین نمیکند که مدل همیشه پاسخ درست بدهد. اگر متن سند بهدرستی استخراج نشده باشد یا بخش مرتبط در مرحله بازیابی پیدا نشود، مدل ممکن است پاسخ ناقص یا نادرست تولید کند. به همین دلیل برای قراردادها و اسناد پزشکی و مالی و حقوقی بهتر است پاسخ هوش مصنوعی صرفاً به عنوان ابزار جستوجو و خلاصهسازی استفاده شود و متن اصلی نیز بررسی شود.
از طرف دیگر باید تفاوت میان «پردازش محلی سند» و «پاسخگویی محلی» را هم در نظر گرفت. LocalRAG برای نمونه دو حالت Local AI و Claude دارد. در حالت Local AI پاسخگویی روی دستگاه انجام میشود اما در حالت Claude سؤال و بخشهای بازیابیشده برای API ارسال میشوند. بنابراین انتخاب موتور پاسخگویی مستقیماً روی مسیر داده اثر میگذارد.
آیا هوش مصنوعی محلی برای خواندن اسناد شخصی مناسب است؟
اگر هدف شما پرسش مکرر از PDFها و اسناد شخصی است و نمیخواهید فایل اصلی را به یک سرویس ابری ارسال کنید، ترکیب مدل زبانی محلی + embedding + RAG میتواند یک جریان کاری کاربردی روی گوشی ایجاد کند.
در اکوسیستم اپل، Noema اکنون علاوه بر اجرای مدل محلی امکان جستوجو و بازیابی از فایلها را نیز ارائه میدهد و در صورت نصب مدلها و دادههای موردنیاز میتواند چت و RAG محلی را بدون اینترنت اجرا کند. برای اندروید نیز LocalRAG گزینهای است که امکان پردازش و جستوجوی محلی اسناد و پاسخگویی با مدل محلی را ارائه میکند.
با این حال برای اسناد حساس بهتر است همیشه وضعیت شبکه و موتور پاسخگویی و تنظیمات برنامه را بررسی کنید. «محلی» بودن مدل به خودی خود کافی نیست و باید مطمئن شوید قابلیتی که استفاده میکنید واقعاً از مسیر محلی استفاده میکند.
گیم پلنت