اجرای مدلهای زبانی بزرگ به اینترنت یا سرویسهای ابری محدود نیست؛ با ابزارهایی مانند LM Studio و بستگی دارد. اگر سختافزار قدرتمندی ندارید، مدلهای کوچک و نسخههای کوانتیده میتوانند راهکار عملیتری باشند.
گیم پلنت: دنیای بازی و سرگرمی
اجرای مدلهای زبانی بزرگ به اینترنت یا سرویسهای ابری محدود نیست؛ با ابزارهایی مانند LM Studio و بستگی دارد. اگر سختافزار قدرتمندی ندارید، مدلهای کوچک و نسخههای کوانتیده میتوانند راهکار عملیتری باشند.
ادامهی مطلب ...
اجرای یک روی کامپیوتر فقط به چت کردن و تولید متن محدود نیست. با ترکیب یک ابزار عاملمحور مانند OpenCode و یک سرویس اجرای مدل مانند LM Studio میتوانید بخشی از کارهای روزمره را بدون مصرف سهمیه سرویسهای ابری انجام دهید؛ کارهایی مانند بررسی فایلها، جستوجوی یادداشتها، توضیح ساختار پروژه و ویرایش تغییرات کوچک.
این روش بهخصوص زمانی مفید است که نمیخواهید برای کارهای ساده از مدلهای قدرتمندی مانند استفاده کنید. البته مدل محلی قرار نیست در تمام پروژهها جایگزین مدلهای ابری شود؛ محدودیت حافظه گرافیکی، طول کانتکست و توانایی مدل در استفاده از ابزارها همچنان اهمیت زیادی دارد.
ادامهی مطلب ...
مدلهای هوش مصنوعی محلی به دلیل اجرای مستقیم روی کامپیوتر میتوانند بدون ارسال داده به سرویس ابری کار کنند و برای کارهایی مثل تولید متن، کدنویسی و خلاصهسازی گزینهای کاربردی باشند. با این حال سرعت اجرای آنها فقط به قدرت پردازنده یا تعداد پارامترهای مدل بستگی ندارد. مقدار VRAM کارت گرافیک و تنظیمات مربوط به Context نیز تأثیر زیادی بر سرعت تولید پاسخ دارند.
اگر مدل نتواند بهطور کامل در حافظه کارت گرافیک قرار بگیرد و بخشی از پردازش به رم سیستم منتقل شود، سرعت تولید توکن میتواند به شکل محسوسی کاهش پیدا کند. در Ollama نیز افزایش Context باعث مصرف بیشتر حافظه میشود و به همین دلیل انتخاب یک مقدار مناسب برای num_ctx یکی از تنظیمات مهم برای سیستمهای دارای VRAM محدود است.
ادامهی مطلب ...
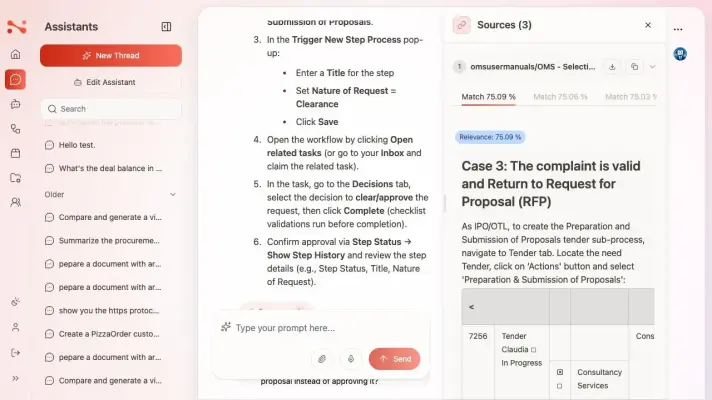
امروزه بسیاری از دستیارهای هوش مصنوعی امکان بارگذاری فایل و پرسش درباره اسناد را فراهم کردهاند. مشکل از جایی شروع میشود که فایل موردنظر حاوی اطلاعات بانکی، قراردادها، اسناد حقوقی، مدارک بیمه یا اطلاعات پزشکی باشد. در چنین شرایطی ارسال فایل به یک سرویس ابری ممکن است با الزامات حریم خصوصی یا سیاستهای شخصی کاربر سازگار نباشد.
هوش مصنوعی محلی میتواند بخشی از این مشکل را حل کند. در این روش مدل زبانی روی خود گوشی اجرا میشود و فایل نیز به جای آپلود روی سرور، در حافظه دستگاه پردازش میشود. البته «محلی بودن» بهتنهایی کافی نیست و باید بررسی کرد که برنامه دقیقاً برای جستوجوی اسناد از چه مسیرهایی استفاده میکند و آیا قابلیتهای آنلاین اختیاری فعال هستند یا نه. مستندات فعلی Noema نیز میان قابلیتهای کاملاً محلی و امکاناتی مانند جستوجوی وب یا مدلهای راه دور تفاوت مشخصی قائل میشود.
ادامهی مطلب ...
برای اجرای هوش مصنوعی محلی لازم نیست تعداد زیادی مدل روی کامپیوتر نصب کنید. معمولاً بهتر است چند مدل با اندازه و توانایی متفاوت داشته باشید و هر کدام را برای کاری مشخص استفاده کنید. یک مدل کوچک میتواند برای پرسشهای روزمره سریعتر باشد و یک مدل بزرگتر برای کدنویسی یا استدلال پیچیدهتر انتخاب شود.
در اجرای محلی، رم و VRAM کارت گرافیک اهمیت زیادی دارند. مدلهای کوانتایز شده نیز به کاهش مصرف حافظه کمک میکنند. به عنوان مثال Google برای Gemma 4 نشان میدهد که نسخه ۱۲B در حالت Q4 حدود ۶.۷ گیگابایت حافظه برای بارگذاری مدل نیاز دارد و مقدار واقعی مصرف حافظه بسته به ابزار اجرا و تنظیمات میتواند بیشتر باشد.
ادامهی مطلب ...
یکی از موضوعات جالب برای افرادی که به بازیهای کامپیوتر و دنیای فیلم و سریال علاقه دارند این است که پاسخ هوش مصنوعی به سوالات اخلاقی و فلسفی چیست؟ آیا همان چیزی است که در فیلمهای علمی و تخیلی مثل ترمیناتور یا Blade Runner دیدهایم یا برعکس، پاسخ متفاوتی میدهد؟
وقتی Claude و چتجیپیتی و Gemini و Gemma 4، جمینی و جمّا ۴ را با یک انتخاب اخلاقی دشوار یا شاید غیرممکن روبهرو میکنیم، پاسخهایشان به شکلهای مختلفی غافلگیرکننده میشوند.
در این مقاله میخواهیم پاسخی که مدلهای محبوب هوش مصنوعی به این سوال میدهد را بررسی کنیم: آیا برای ساخت واکسن و نجات بشریت، یک انسان را فدا کنیم یا خیر؟ این دقیقاً چالشی است که برای شخصیت اول بازی The Last of Us اتفاق افتاده است و بیشتر گیمرها پاسخی که کاراکتر Joel داده را میدانند. با گیم پلنت همراه باشید تا پاسخ هوش مصنوعی را ببینیم.
ادامهی مطلب ...