برای اجرای هوش مصنوعی محلی لازم نیست تعداد زیادی مدل روی کامپیوتر نصب کنید. معمولاً بهتر است چند مدل با اندازه و توانایی متفاوت داشته باشید و هر کدام را برای کاری مشخص استفاده کنید. یک مدل کوچک میتواند برای پرسشهای روزمره سریعتر باشد و یک مدل بزرگتر برای کدنویسی یا استدلال پیچیدهتر انتخاب شود.
در اجرای محلی، رم و VRAM کارت گرافیک اهمیت زیادی دارند. مدلهای کوانتایز شده نیز به کاهش مصرف حافظه کمک میکنند. به عنوان مثال Google برای Gemma 4 نشان میدهد که نسخه ۱۲B در حالت Q4 حدود ۶.۷ گیگابایت حافظه برای بارگذاری مدل نیاز دارد و مقدار واقعی مصرف حافظه بسته به ابزار اجرا و تنظیمات میتواند بیشتر باشد.
برای اجرای مدل های هوش مصنوعی محلی چه سخت افزاری لازم است؟
برای مدلهای محلی، داشتن GPU انویدیا با VRAM مناسب میتواند سرعت اجرای مدل را به شکل محسوسی افزایش دهد. KoboldCpp از مدلهای GGUF استفاده میکند و در ویندوز امکان استفاده از شتابدهی CUDA و انتقال لایههای مدل به GPU را دارد. هرچه لایههای بیشتری در VRAM قرار بگیرند، سرعت تولید پاسخ میتواند بیشتر شود؛ البته تا زمانی که حافظه کارت گرافیک کافی باشد.
یک سیستم با ۳۲ گیگابایت رم، کارت گرافیک انویدیا با ۱۲ گیگابایت VRAM و یک SSD سریع میتواند برای بسیاری از مدلهای کوانتایز شده در محدوده متوسط مناسب باشد. مدلهای بزرگتر ممکن است به رم بیشتر یا اجرای ترکیبی CPU و GPU نیاز داشته باشند.
KoboldCpp چیست و چرا برای اجرای مدل محلی کاربردی است؟
KoboldCpp یک نرمافزار نسبتاً ساده برای اجرای مدلهای GGUF روی کامپیوتر شخصی است. نسخه ویندوز آن به صورت یک فایل اجرایی ارائه میشود و برای شروع معمولاً نیازی به نصب پیچیده ندارد. این برنامه از شتابدهی GPU و تنظیم تعداد لایههای منتقلشده به GPU پشتیبانی میکند.
مسیر کلی استفاده:
KoboldCpp > انتخاب مدل GGUF > تنظیم GPU Layers > Launch
برای کارتهای گرافیک انویدیا میتوان از شتابدهی CUDA استفاده کرد. اگر VRAM کافی نباشد، بخشی از مدل میتواند در رم سیستم باقی بماند؛ در این حالت سرعت اجرا معمولاً پایینتر خواهد بود.
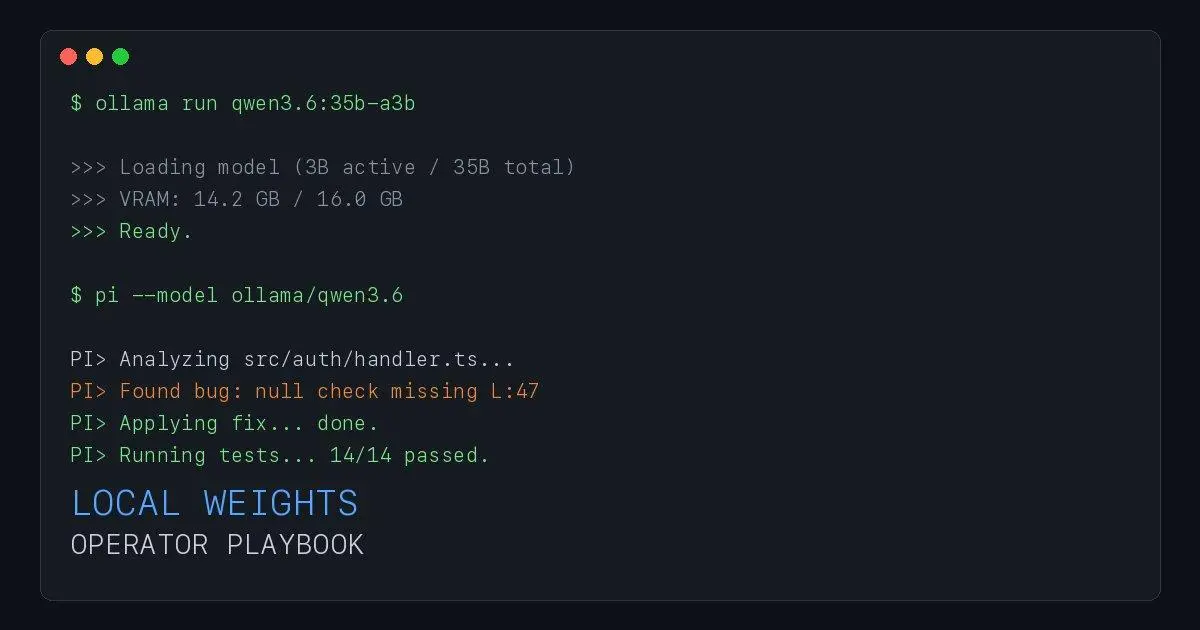
Qwen3.6 27B برای کدنویسی و پروژه های پیچیده
Qwen3.6 27B یک مدل متراکم با حدود ۲۷ میلیارد پارامتر است که قابلیتهای چندوجهی و تمرکز ویژهای روی کدنویسی عاملمحور دارد. Qwen برای این مدل زمینه متنی بومی ۲۵۶ هزار توکن را اعلام کرده و امکان گسترش آن تا بیش از یک میلیون توکن نیز ذکر شده است.
نسخههای کوانتایز شده آن برای اجرای محلی جذابتر هستند. برای کدنویسی، دیباگ، بازنویسی و بررسی پروژههای بزرگ میتوان از یک مدل ۲۷B استفاده کرد؛ البته سرعت آن به کوانتایز، VRAM و مقدار لایههای قرارگرفته روی GPU بستگی دارد.
برای سیستمی با VRAM محدود، نسخههای Q4 یا Q5 معمولاً نقطه شروع عملیتری نسبت به اجرای مدل با دقت بالاتر هستند.
Gemma 4 12B برای استفاده روزمره و پاسخ سریع
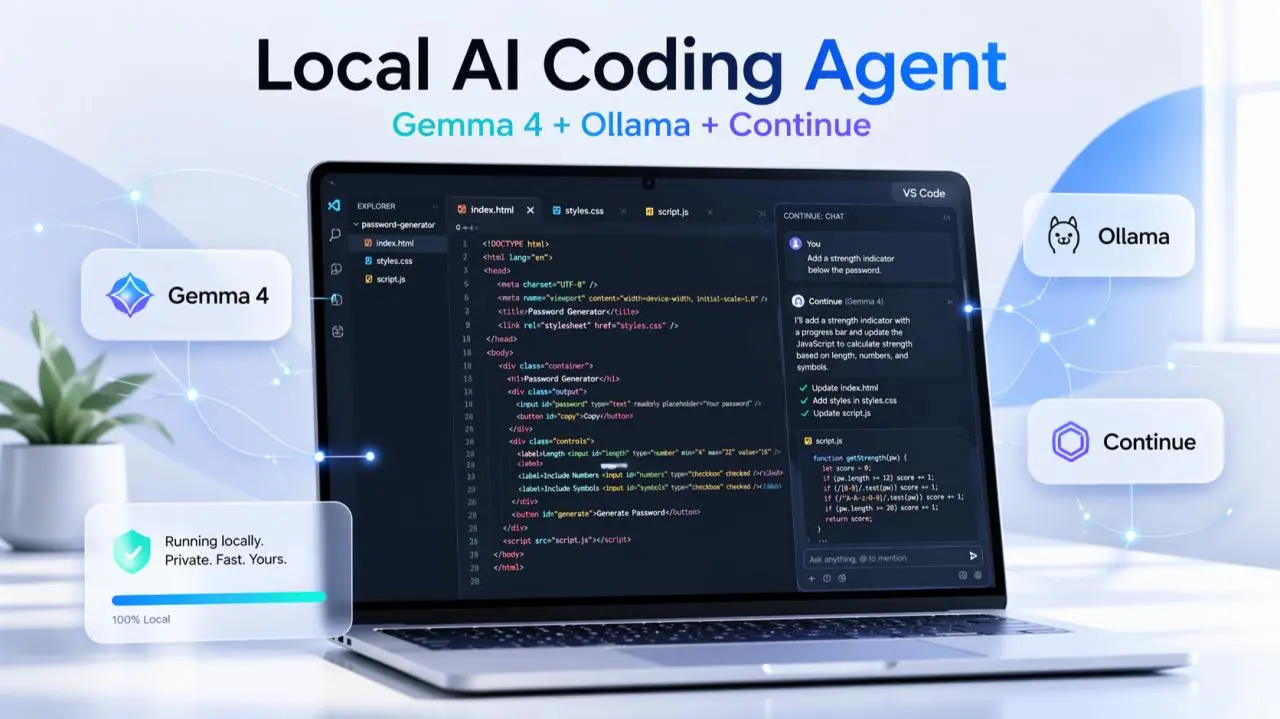
Gemma 4 12B برای اجرای محلی در لپتاپها و کامپیوترهای شخصی طراحی شده و علاوه بر متن، از ورودی تصویر و صدا نیز پشتیبانی میکند. گوگل برای این مدل پنجره زمینه ۲۵۶ هزار توکن را اعلام کرده است.
برای پرسشهای روزمره، خلاصهسازی، توضیح مفاهیم، ایدهپردازی و بعضی کارهای کدنویسی میتوان از آن استفاده کرد. مزیت مهم نسخه ۱۲B نسبت به مدلهای بزرگتر، نیاز کمتر به منابع است.
گوگل برای Gemma 4 12B حدود ۶.۷ گیگابایت حافظه در Q4_0 و حدود ۱۳.۴ گیگابایت در SFP8 را به عنوان نیاز تقریبی بارگذاری مدل اعلام کرده است. این اعداد شامل برآورد مشخصی از سربار اجرای مدل هستند و مصرف واقعی میتواند با توجه به نرمافزار و اندازه Context تغییر کند.
GPT-OSS 20B برای استدلال و حل مسائل چندمرحله ای
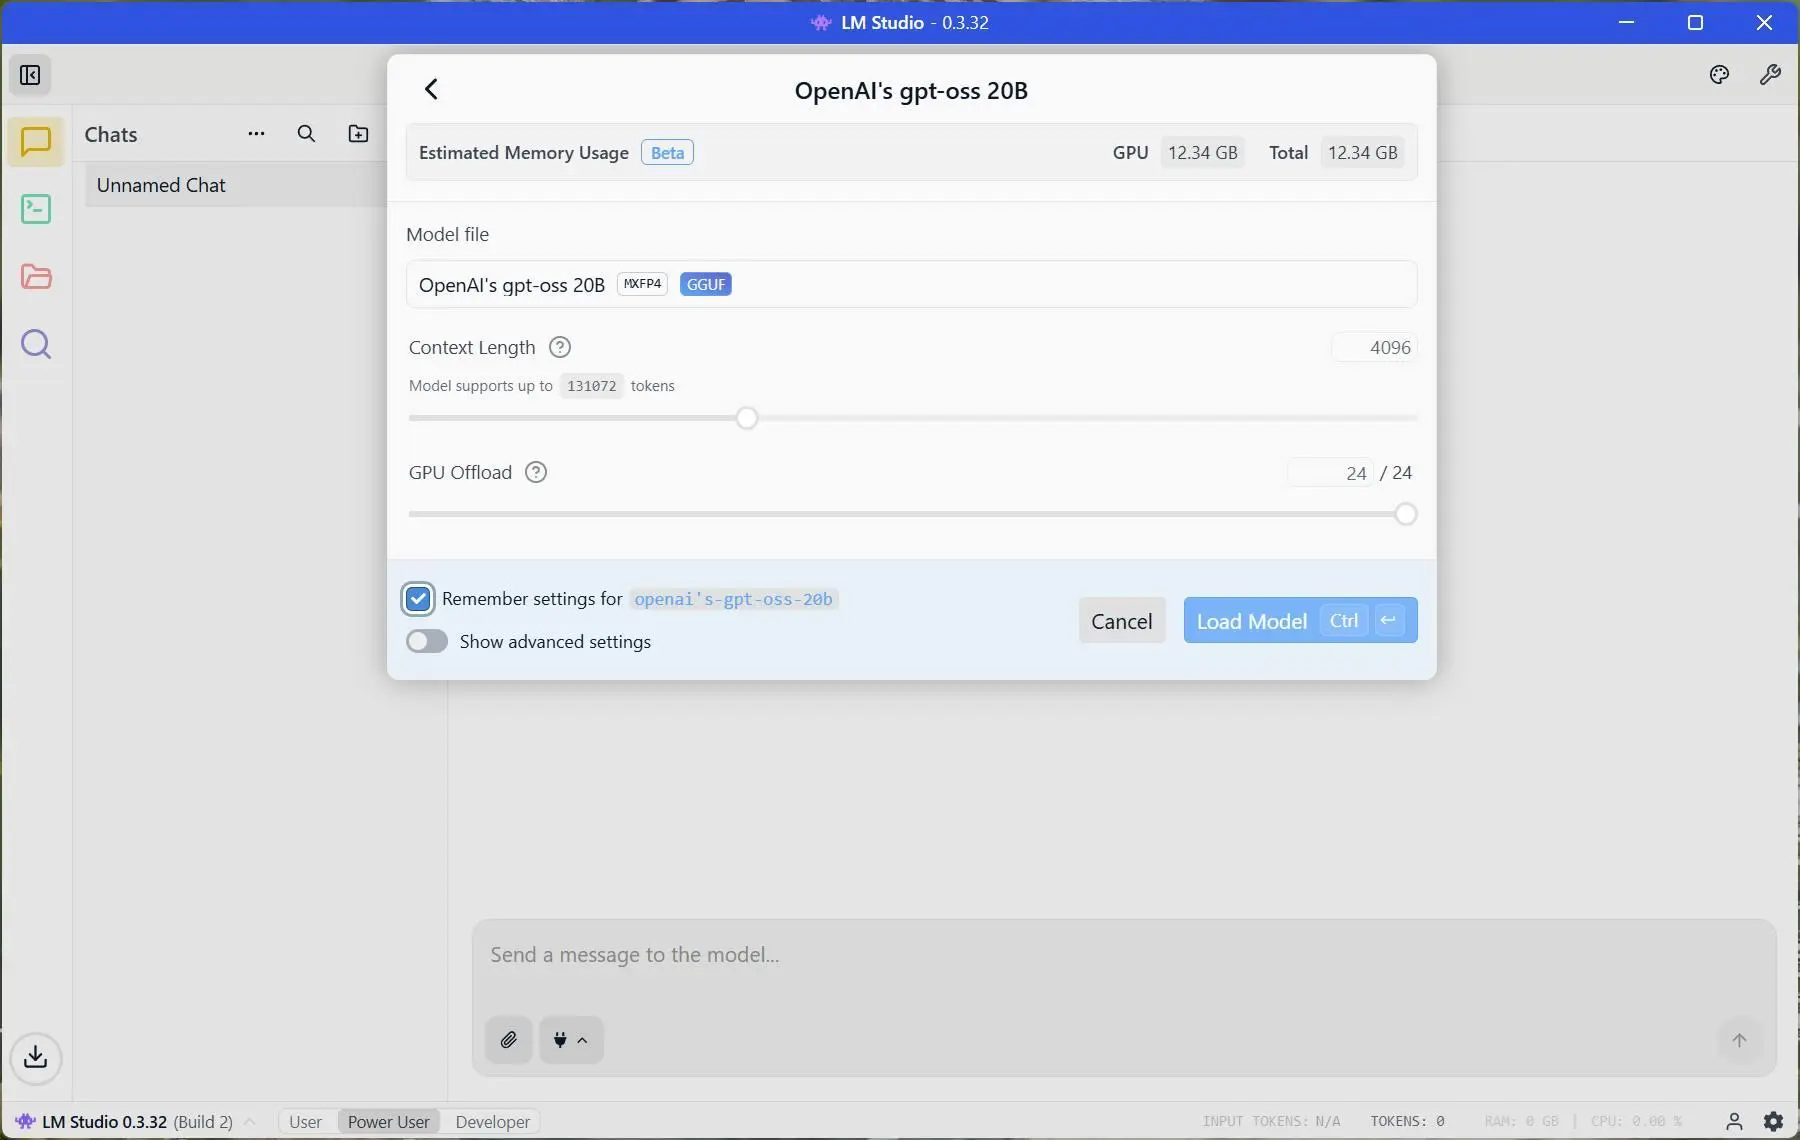
GPT-OSS 20B یکی از مدلهای OpenAI برای اجرای محلی است. این مدل در مجموع حدود ۲۱ میلیارد پارامتر دارد اما فقط حدود ۳.۶ میلیارد پارامتر در هر توکن فعال میشوند. OpenAI آن را برای اجرای محلی و سناریوهایی که به تأخیر پایینتر نیاز دارند معرفی کرده است.
قابلیت تنظیم سطح استدلال در این مدل باعث میشود برای مسائل چندمرحلهای، تحلیل، کدنویسی و کارهایی که نیاز به بررسی دقیقتر دارند کاربردی باشد. نسخه رسمی آن نیز با قالب MXFP4 ارائه شده و OpenAI اعلام کرده که مدل ۲۰B با حدود ۱۶ گیگابایت حافظه قابل اجرا است.
برای اجرای محلی، این مدل را میتوان با ابزارهایی مانند llama.cpp و برخی رابطهای اجرای مدل استفاده کرد. در انتخاب نسخه GGUF یا کوانتایز شده باید سازگاری آن با نرمافزار مورد استفاده را بررسی کنید.
Llama 3.3 برای نویسندگی و ایده پردازی مناسب است؟
اینجا باید یک اصلاح مهم در نام مدل انجام داد: Llama 3.3 رسمی در اندازه ۷۰B عرضه شده است و مدل رسمی ۸B مربوط به نسلهای قبلی Llama است. فهرست رسمی Meta نیز Llama 3.3 را در اندازه ۷۰B معرفی میکند.
بنابراین اگر فایلی با نام Llama 3.3 8B میبینید، احتمالاً با یک نسخه تغییر یافته، مدل مشتق شده یا نامگذاری غیررسمی روبهرو هستید و نباید آن را با مدل رسمی Llama 3.3 اشتباه گرفت.
برای اجرای محلی سبکتر، مدلهای ۸B از خانواده Llama همچنان میتوانند برای نویسندگی، ایدهپردازی و گفتوگوی روزمره کاربرد داشته باشند. مدل رسمی Llama 3 نیز در اندازه ۸B و ۷۰B عرضه شده بود.
آیا برای هوش مصنوعی محلی فقط یک مدل کافی است؟
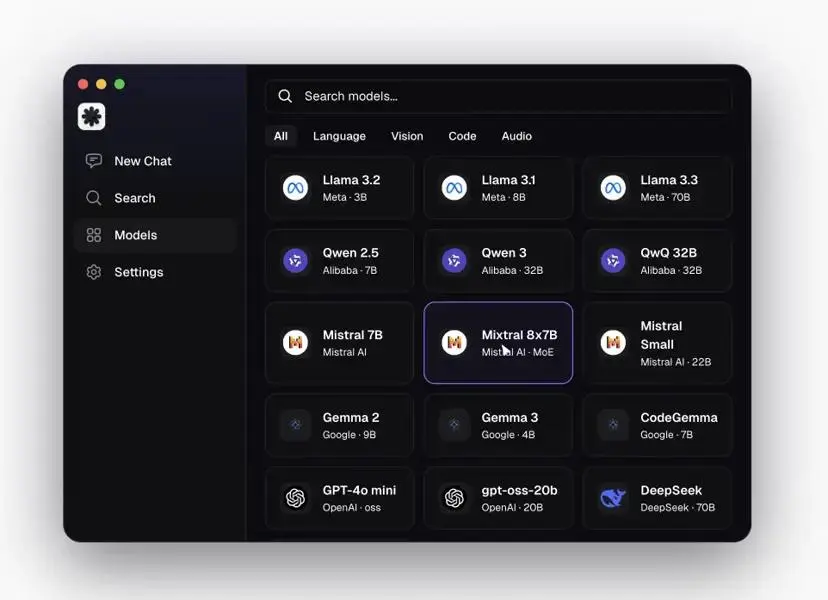
معمولاً داشتن چند مدل با کاربردهای متفاوت منطقیتر از استفاده اجباری از یک مدل برای همه کارهاست. میتوانید یک مدل کوچک را برای پاسخهای سریع نگه دارید و مدلهای بزرگتر را فقط زمانی اجرا کنید که به کدنویسی، استدلال یا پردازش طولانیتر نیاز دارید.
ترکیب پیشنهادی میتواند چنین ساختاری داشته باشد:
- مدل کوچک: پرسشهای روزمره و پاسخ سریع
- مدل متوسط: خلاصهسازی، کدنویسی معمولی و تحلیل
- مدل بزرگتر: پروژههای پیچیده و کدنویسی سنگین
- مدل استدلالی: مسائل چندمرحلهای و تحلیل عمیق
این روش باعث میشود VRAM و رم سیستم فقط زمانی درگیر مدلهای سنگین شوند که واقعاً به آنها نیاز دارید.
جمع بندی بهترین مدل های هوش مصنوعی محلی
انتخاب مدل به جای استفاده از یک گزینه برای همه کارها بهتر است بر اساس اندازه مدل، مقدار VRAM، سرعت موردنیاز و نوع کار انجام شود. Qwen3.6 27B برای کدنویسی و کارهای چندوجهی گزینهای قدرتمند در رده مدلهای ۲۷B است. Gemma 4 12B برای اجرای محلی روی کامپیوترهای شخصی طراحی شده و GPT-OSS 20B نیز برای استدلال و استفاده محلی گزینهای مهم است.
برای اجرای این مدلها نیز KoboldCpp یکی از گزینههای ساده برای مدلهای GGUF است و امکان استفاده از GPU و تنظیم GPU Layers را فراهم میکند.
گیم پلنت