اجرای مدلهای زبانی بزرگ به اینترنت یا سرویسهای ابری محدود نیست؛ با ابزارهایی مانند LM Studio و بستگی دارد. اگر سختافزار قدرتمندی ندارید، مدلهای کوچک و نسخههای کوانتیده میتوانند راهکار عملیتری باشند.
گیم پلنت: دنیای بازی و سرگرمی
اجرای مدلهای زبانی بزرگ به اینترنت یا سرویسهای ابری محدود نیست؛ با ابزارهایی مانند LM Studio و بستگی دارد. اگر سختافزار قدرتمندی ندارید، مدلهای کوچک و نسخههای کوانتیده میتوانند راهکار عملیتری باشند.
ادامهی مطلب ...
استفاده روزانه از مدلهای قدرتمند هوش مصنوعی مانند و ChatGPT میتواند هزینهبر باشد؛ بهخصوص زمانی که برای برنامهنویسی، ساخت پروژه و تحلیل فایلها از آنها استفاده میکنید. علاوه بر هزینه اشتراک، محدودیت تعداد درخواستها و سهمیه مصرف نیز ممکن است باعث شود در میانه انجام یک پروژه نتوانید از مدل دلخواهتان استفاده کنید.
یکی از راهکارهای کاهش مصرف سهمیه هوش مصنوعی، تقسیم وظایف بین چند مدل مختلف است. به جای اینکه تمام درخواستها را به قدرتمندترین مدل ارسال کنید، میتوانید کارهای ساده را به مدلهای رایگان بسپارید و از مدلهای پیشرفته فقط برای وظایف پیچیده استفاده کنید. برنامه متنباز OpenCode این امکان را فراهم میکند که چند ارائهدهنده و مدل را در یک محیط مدیریت کنید.
ادامهی مطلب ...
Mistral Large 4 یکی از مهمترین مدلهای هوش مصنوعی معرفیشده در سال ۲۰۲۶ است که با هدف نزدیک کردن مدلهای دارای وزن باز به مدلهای قدرتمند تجاری عرضه شده است. این مدل که با نام غیررسمی Le Chonk نیز شناخته میشود، در حال حاضر به صورت پیشنمایش عمومی در اختیار کاربران و توسعهدهندگان قرار گرفته و قرار است وزنهای آن نیز در ادامه ماه منتشر شود.
نکته مهم این است که Mistral Large 4 هنوز با یک مدل کاملاً آماده برای اجرای محلی فاصله دارد. نسخه فعلی بیشتر برای آزمایش از طریق API طراحی شده است و تا زمانی که وزنهای نهایی منتشر نشوند، امکان اجرای کامل مدل روی سختافزار شخصی وجود ندارد. به همین دلیل، برای بیشتر کاربران عادی فعلاً نباید آن را جایگزین مستقیم ChatGPT یا سایر دستیارهای هوش مصنوعی دانست.
ادامهی مطلب ...
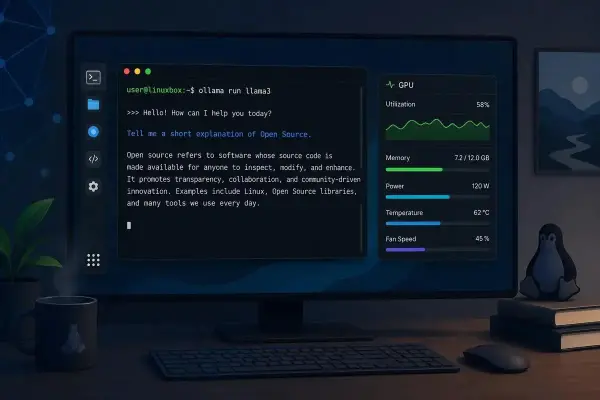
وقتی یک مدل هوش مصنوعی را با Ollama اجرا میکنید، مقدار حافظه موردنیاز فقط به حجم فایل مدل بستگی ندارد. اندازه پنجره Context نیز میتواند مقدار قابلتوجهی از RAM یا VRAM را مصرف کند، حتی اگر در عمل از تمام ظرفیت آن استفاده نکنید. بنابراین اگر معمولاً با مکالمههای کوتاه چند هزار توکنی کار میکنید، کاهش Context میتواند یکی از سادهترین روشها برای آزاد کردن حافظه و جلوگیری از کندشدن سیستم باشد.
ادامهی مطلب ...
هوش مصنوعی محلی دیگر محدود به چند برنامه شناختهشده نیست و پروژههای متنباز متنوعی برای اجرای مدلها روی کامپیوتر شخصی وجود دارند. بعضی از این ابزارها برای چت و اجرای مدلهای زبانی ساخته شدهاند و بعضی دیگر روی برنامهنویسی، جستوجوی اسناد، تبدیل صدا به متن یا اجرای وظایف چندمرحلهای تمرکز دارند. این تنوع باعث میشود بتوان یک محیط هوش مصنوعی محلی را متناسب با سختافزار و نیاز واقعی خود ساخت.
ادامهی مطلب ...
وقتی فایلهای حساس را برای پردازش به سرویسهای هوش مصنوعی ابری میفرستید، اطلاعات شما از کامپیوتر خارج شده و روی زیرساخت یک شرکت دیگر پردازش میشود. برای اسناد پزشکی، قراردادها، اطلاعات مالی، کدهای اختصاصی و فایلهای شخصی، اجرای مدل هوش مصنوعی روی کامپیوتر میتواند رویکرد متفاوتی باشد؛ چون در حالت کاملاً محلی، فایل برای پردازش به سرویس ابری ارسال نمیشود. ابزارهایی مانند Ollama نیز اجرای مدلهای محلی را روی دستگاه کاربر پشتیبانی میکنند.
البته اجرای محلی به معنی حذف تمام خطرات امنیتی نیست. اگر خود کامپیوتر آلوده باشد یا مدل و نرمافزار اجراکننده از منبع نامطمئن دریافت شده باشند، اطلاعات همچنان در معرض خطر قرار میگیرند. مزیت اصلی این روش این است که برای پردازش محلی، اطلاعات نیازی به عبور از سرویس هوش مصنوعی ابری ندارد.
ادامهی مطلب ...