اجرای مدلهای زبانی بزرگ به اینترنت یا سرویسهای ابری محدود نیست؛ با ابزارهایی مانند LM Studio و Ollama میتوان بعضی مدلهای هوش مصنوعی را روی کامپیوتر شخصی اجرا کرد. انتخاب مدل مناسب به نوع استفاده، مقدار حافظه رم و قدرت کارت گرافیک بستگی دارد. اگر سختافزار قدرتمندی ندارید، مدلهای کوچک و نسخههای کوانتیده میتوانند راهکار عملیتری باشند.
بهترین مدلهای هوش مصنوعی کوچک برای اجرا روی کامپیوتر
چهار مدل زیر کاربردهای متفاوتی دارند و قرار نیست همگی برای یک کار مناسب باشند. بعضی برای استدلال و کارهای روزمره بهترند، بعضی در برنامهنویسی عملکرد قویتری دارند و بعضی برای تولید متن خلاقانه یا اجرا روی سیستمهای کممصرف طراحی شدهاند.
Qwen3.8-9B-Distill؛ مدل کوچک برای استدلال و کارهای عمومی
کاربرد اصلی: پرسشوپاسخ، خلاصهسازی، تحلیل متن و استفاده از ابزارها
این مدل نسخه تقطیرشدهای از یک مدل بزرگتر است که با حدود ۹ میلیارد پارامتر، تلاش میکند بخشی از تواناییهای استدلالی مدل اصلی را در ابعادی کوچکتر ارائه دهد. برای پاسخ به پرسشهای عمومی، دنبالکردن دستورالعملها و خلاصهسازی اسناد گزینه قابل بررسی است. نسخه معرفیشده از قابلیت فراخوانی ابزار و پردازش تصویر نیز پشتیبانی میکند؛ البته برای استفاده تصویری ممکن است به فایل جانبی مخصوص نیاز داشته باشید.
نسخه GGUF با کوانتایزیشن چهار بیتی Q4_K_M حدود ۵.۸ گیگابایت حجم دارد. این نسخه برای کارتهای گرافیک با حافظه محدود مناسبتر است، اما حافظه مورد نیاز فقط به حجم فایل مدل محدود نمیشود و پنجره متن و حافظه کش نیز اهمیت دارند.
Ornith-1.5-9B؛ گزینهای برای برنامهنویسی خودکار
کاربرد اصلی: تولید کد، اصلاح خطا و انجام وظایف چندمرحلهای برنامهنویسی
Ornith-1.5-9B برای برنامهنویسی عاملمحور طراحی شده است؛ یعنی فقط یک قطعه کد تولید نمیکند، بلکه میتواند برای حل مسئله برنامهریزی کند، راهحل را آزمایش کند و در صورت نیاز آن را اصلاح کند. این ویژگی برای ساخت ابزارهای کوچک، اسکریپتها و پروژههای محدود مفید است.
نسخه اصلی این مدل با دقت BF16 حدود ۱۹ گیگابایت حجم دارد و برای اجرای مستقیم به سختافزار قدرتمندی نیازمند است. برای کامپیوترهای خانگی باید سراغ نسخههای کوانتیده GGUF بروید و سازگاری نسخه انتخابی با موتور اجرا را بررسی کنید. همچنین برای استفاده از قابلیتهای جدید آن، نسخههای بهروز موتورهایی مانند llama.cpp یا Ollama اهمیت دارند.
Qwythos-9B-v2؛ مناسب نوشتن خلاقانه و نقشآفرینی
کاربرد اصلی: داستاننویسی، گفتوگوهای خلاقانه و تولید متن آزاد
Qwythos-9B-v2 بر پایه خانواده Qwen3.5 ساخته شده و برای مکالمه و تولید متن خلاقانه بهینه شده است. یکی از تغییرات نسخه دوم، کاهش تکرارهای ناخواسته و گیرکردن مدل در چرخه پاسخهای مشابه است. این ویژگی میتواند هنگام نوشتن داستانهای طولانی و گفتوگوهای چندمرحلهای مفید باشد.
این مدل نسخه GGUF نیز دارد و میتوان آن را با موتورهای سازگار اجرا کرد. با این حال، پنجره متن بسیار بزرگ به حافظه بیشتری نیاز دارد؛ بنابراین بهتر است ابتدا با مقدار متوسط شروع کنید و فقط در صورت نیاز آن را افزایش دهید.
Llama 3.2 3B Instruct؛ مدل سبک برای سیستمهای ضعیف
کاربرد اصلی: دستیار محلی ساده، خلاصهسازی و پرسش از اطلاعات ذخیرهشده
این مدل با حدود ۳ میلیارد پارامتر، در مقایسه با مدلهای ۹ میلیاردی سبکتر است و برای کارهایی مانند گفتوگوی روزمره، خلاصهسازی و دنبالکردن دستورالعملها کاربرد دارد. اگر قصد دارید یک دستیار هوش مصنوعی محلی روی کامپیوتر قدیمی یا مینیپیسی کممصرف داشته باشید، هنوز میتواند گزینهای قابل بررسی باشد.
البته Llama 3.2 نسل جدیدی از مدلهای متا نیست و در مقایسه با مدلهای تازهتر ممکن است در استدلال پیچیده و برنامهنویسی ضعیفتر باشد. مزیت اصلی آن مصرف منابع کمتر است، نه ارائه بهترین کیفیت پاسخ.
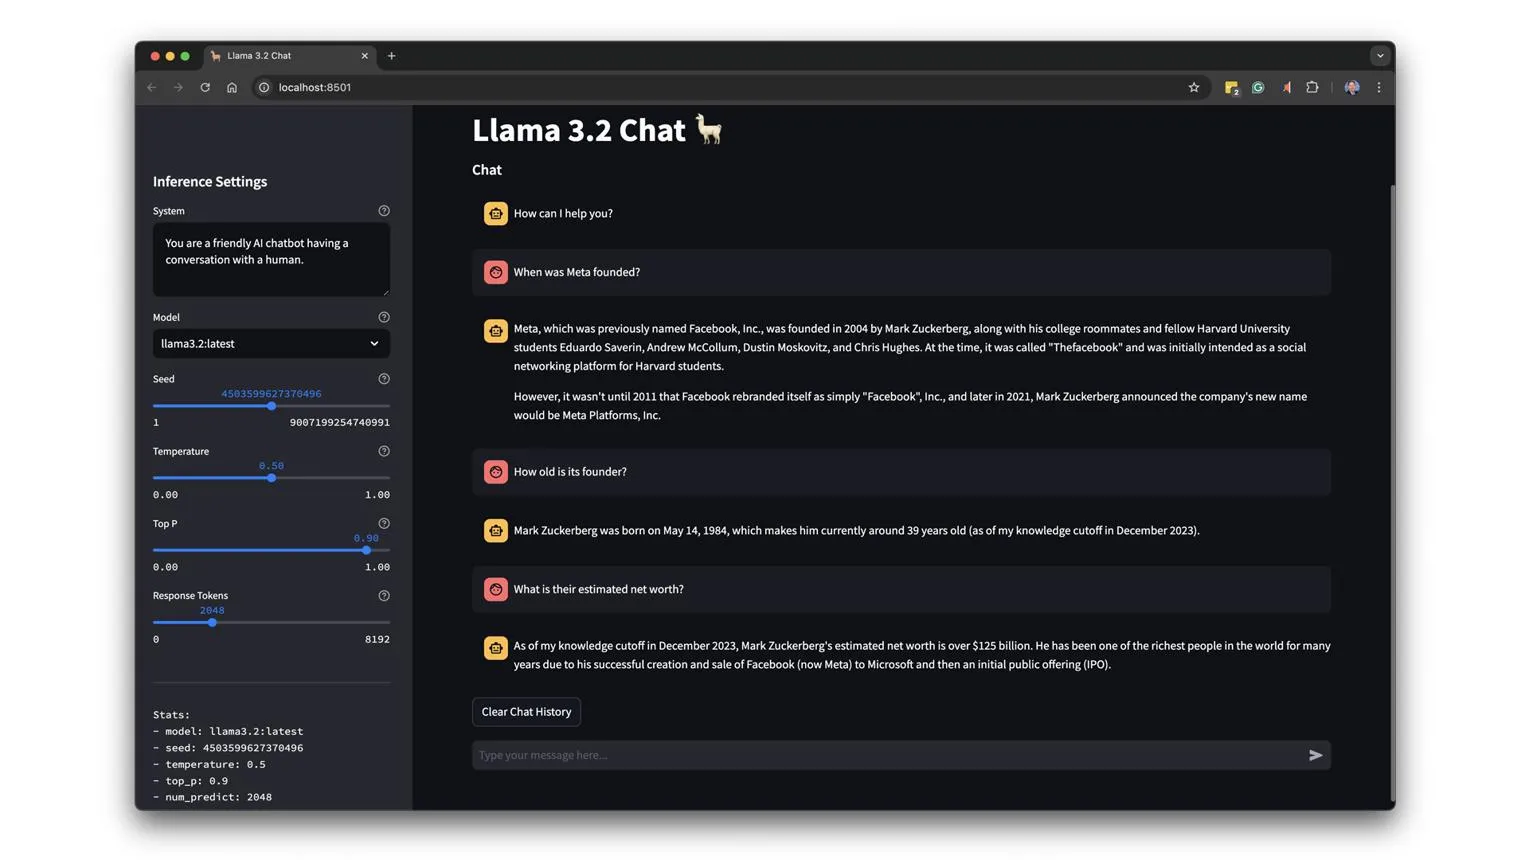
چگونه این مدلهای هوش مصنوعی را روی کامپیوتر اجرا کنیم؟
برای اجرای مدلهای هوش مصنوعی محلی میتوانید از دو برنامه LM Studio و Ollama استفاده کنید. هر دو امکان مدیریت مدلها و اجرای آنها روی کامپیوتر شخصی را فراهم میکنند؛ اما باید نسخهای را دانلود کنید که با سختافزار و موتور اجرای شما سازگار باشد.
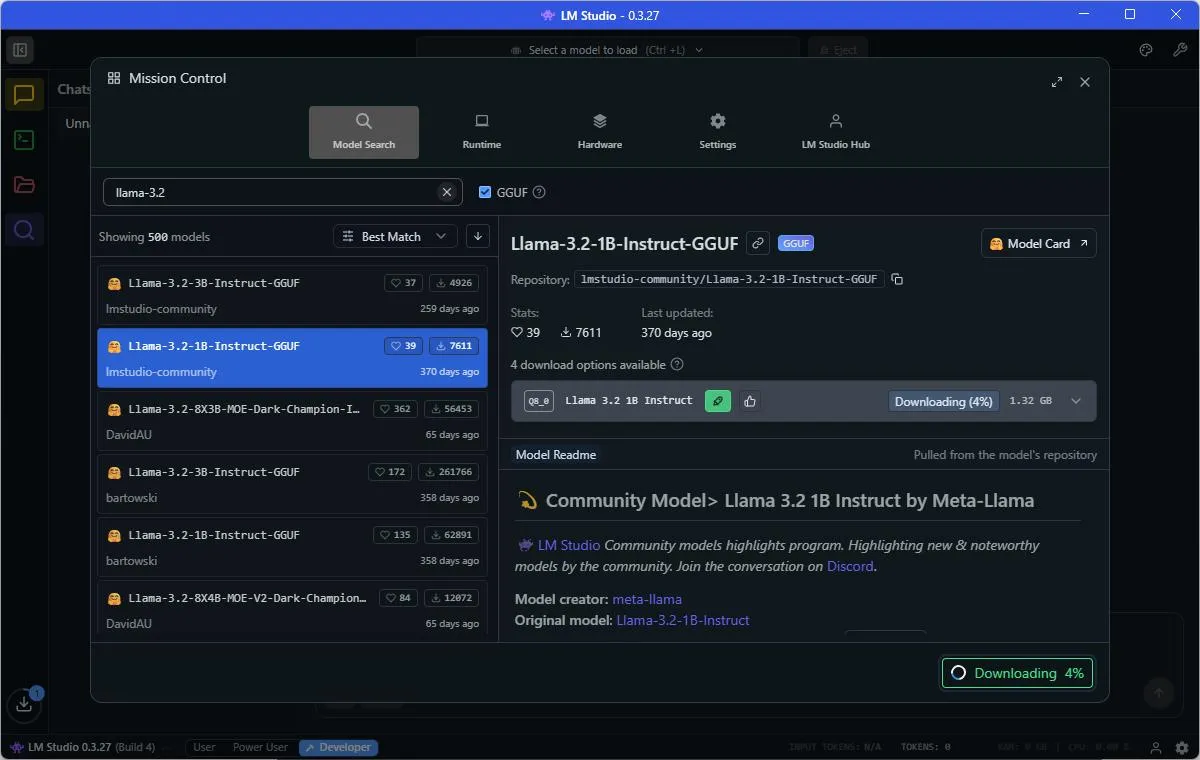
تنظیم مدل در LM Studio
- برنامه LM Studio را نصب و اجرا کنید.
- وارد بخش جستوجوی مدلها شوید و نام مدل مورد نظر را وارد کنید.
- در صورت وجود چند نسخه، نسخه GGUF با کوانتایزیشن Q4_K_M را برای شروع انتخاب کنید.
- پس از دانلود، مدل را بارگذاری کنید و یک گفتوگوی جدید بسازید.
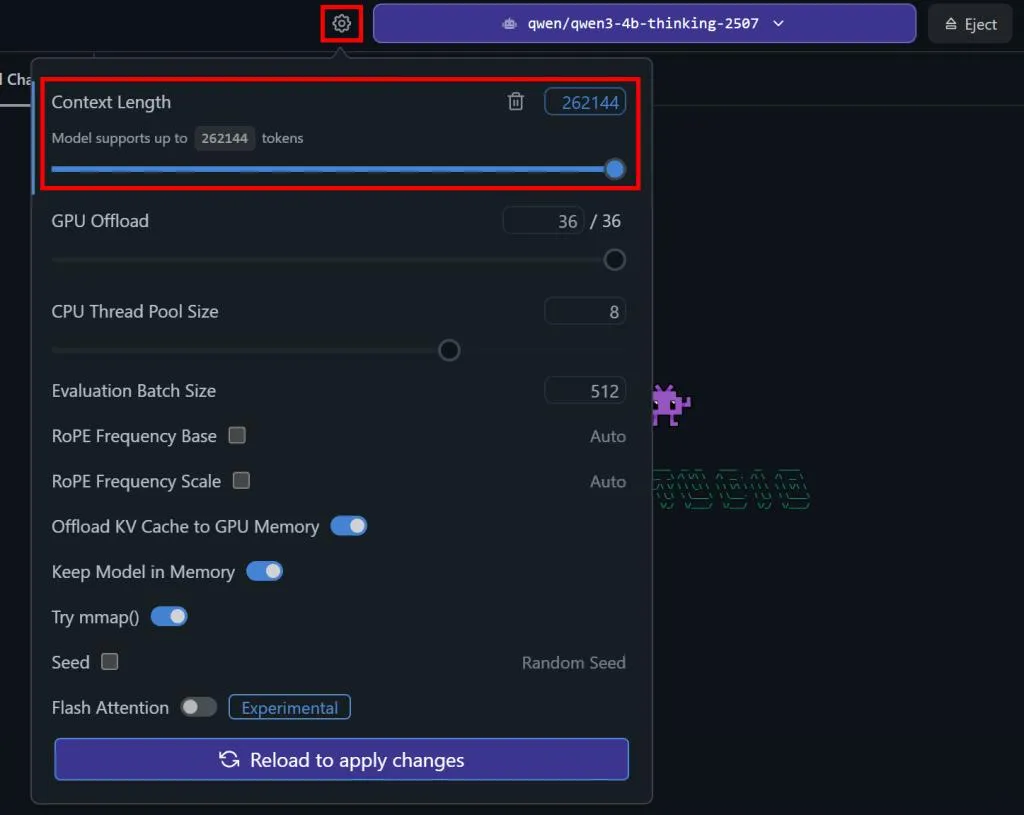
- اگر حافظه سیستم کافی نیست، پنجره متن یا Context Length را کاهش دهید.
اجرای مدل با Ollama
در Ollama نیز میتوانید مدلهای سازگار را از کتابخانه برنامه دریافت کنید. برای مدلهایی که نسخه GGUF اختصاصی دارند، ابتدا از وجود فایل مناسب و پشتیبانی نسخه نصبشده Ollama مطمئن شوید. همچنین با دستور ollama ps میتوانید بررسی کنید مدل چه مقدار از پردازش را روی GPU و چه مقدار را روی CPU انجام میدهد.
بهترین تنظیمات برای اجرای مدلهای کوچک با رم و VRAM محدود
حجم فایل مدل تنها عامل تعیینکننده نیست. پنجره متن، حافظه کش و میزان پردازش واگذارشده به کارت گرافیک نیز روی مصرف منابع تأثیر دارند. برای شروع این تنظیمات را در نظر بگیرید:
- Q4_K_M: انتخاب مناسبی برای کاهش حجم مدل و اجرای آن روی کارتهای گرافیک محدود است.
- Context Length: ابتدا مقدار ۴۰۹۶ یا ۸۱۹۲ توکن را امتحان کنید و فقط در صورت نیاز آن را افزایش دهید.
- KV Cache: در صورت پشتیبانی برنامه، حالت Q8_0 میتواند مصرف حافظه کش را کاهش دهد.
- پردازش GPU: تا جایی که حافظه گرافیکی اجازه میدهد، بخش بیشتری از مدل را روی GPU بارگذاری کنید.
برای مدل ۹ میلیارد پارامتری، نسخه Q4_K_M ممکن است چندین گیگابایت از VRAM را اشغال کند؛ بنابراین باید برای حافظه کش و پردازشهای دیگر نیز فضای کافی باقی بگذارید. افزایش بیرویه پنجره متن هم میتواند باعث کندشدن مدل یا انتقال بخشی از پردازش به RAM شود.
برای انتخاب سریع، اگر برنامهنویسی اولویت شماست Ornith-1.5-9B را بررسی کنید؛ برای کارهای عمومی Qwen3.8-9B-Distill گزینه مناسبی است و برای نوشتن خلاقانه میتوانید Qwythos-9B-v2 را امتحان کنید. اگر سیستم بسیار ضعیفی دارید، Llama 3.2 3B Instruct سبکتر است. البته برای سختافزار محدود، یک مدل ۴ میلیارد پارامتری جدید و کوانتیده نیز ممکن است از مدل ۹ میلیاردی قدیمی تجربه روانتری ارائه دهد.
گیم پلنت