اجرای مدلهای زبانی بزرگ (LLM) روی کامپیوتر شخصی، بدون ارسال اطلاعات به سرویسهای آنلاین، به یکی از کاربردهای جذاب هوش مصنوعی محلی تبدیل شده است. با این حال، اجرای مدلهای بزرگ روی کارت گرافیکهای قدیمی یا اقتصادی همیشه ساده نیست؛ زیرا حافظه گرافیکی محدود میتواند اندازه مدل قابل اجرا و سرعت تولید پاسخ را محدود کند.
یکی از راهکارهای کاربردی برای عبور از این محدودیت، استفاده از معماری Mixture of Experts یا MoE است. این معماری به مدل اجازه میدهد برای پردازش هر ورودی فقط از بخشی از شبکه استفاده کند. در نتیجه، بعضی مدلهای MoE با وجود داشتن تعداد پارامترهای بسیار زیاد، میتوانند روی سیستمهایی با حافظه گرافیکی محدود نیز قابل اجرا باشند؛ البته سرعت نهایی به مدل، میزان فشردهسازی، حافظه رم و تنظیمات نرمافزار بستگی دارد.
چرا اجرای مدلهای زبانی بزرگ به حافظه گرافیکی زیادی نیاز دارد؟
در مدلهای زبانی متداول با معماری متراکم (Dense)، تقریباً تمام پارامترهای شبکه هنگام پردازش هر توکن در محاسبات مشارکت میکنند. به همین دلیل، برای اجرای سریع مدل معمولاً باید بخش عمده وزنهای آن در حافظه گرافیکی یا VRAM جا بگیرد. هرچه تعداد پارامترهای مدل بیشتر باشد، حافظه بیشتری برای بارگذاری آن نیاز خواهد بود.
اگر VRAM کافی نباشد، بعضی نرمافزارهای اجرای مدل میتوانند بخشی از وزنها را در حافظه رم سیستم قرار دهند. این روش امکان اجرای مدلهای بزرگتر را فراهم میکند، اما انتقال داده میان رم و حافظه گرافیکی از طریق گذرگاه PCIe ممکن است سرعت تولید توکن را بهشدت کاهش دهد. بنابراین، بارگذاری موفق یک مدل الزاماً به معنای اجرای روان آن نیست.
فشردهسازی وزنهای مدل یا Quantization نیز راه دیگری برای کاهش مصرف حافظه است. به عنوان مثال، مدلهای فشردهشده با قالب Q4 معمولاً حافظه کمتری نسبت به نسخههای دقیقتر مصرف میکنند؛ اما میزان افت کیفیت و سرعت به مدل و روش فشردهسازی بستگی دارد. به همین دلیل، انتخاب مدل باید بر اساس ظرفیت واقعی سیستم و نوع کاری که قرار است انجام دهد صورت بگیرد.
برای درک تقریبی نیاز حافظه، یک مدل ۷ میلیارد پارامتری با کوانتیزهسازی Q4 ممکن است حدود ۴ تا ۵٫۵ گیگابایت حافظه برای وزنها نیاز داشته باشد. مصرف واقعی بیشتر خواهد بود؛ زیرا حافظه لازم برای بافرها، زمینه ورودی و سایر اجزای زمان اجرا نیز باید در نظر گرفته شود.
معماری MoE چگونه اجرای مدلهای بزرگ را روی GPU ضعیفتر ممکن میکند؟
مدلهای MoE بهجای استفاده از یک شبکه متراکم واحد در همه بخشها، چند شبکه تخصصیتر به نام Expert دارند. یک سازوکار مسیریابی (Router) مشخص میکند که هر توکن برای پردازش به کدام متخصصها فرستاده شود. در نتیجه، برای هر توکن فقط بخشی از پارامترهای مدل فعال میشوند و بقیه متخصصها در همان محاسبه مشارکت نمیکنند.
این تفاوت باعث میشود تعداد کل پارامترهای یک مدل MoE با تعداد پارامترهای فعال آن یکسان نباشد. به عنوان مثال، نام مدلی مانند Qwen3.6-35B-A3B نشان میدهد که مدل در مجموع حدود ۳۵ میلیارد پارامتر دارد و در هر توکن تقریباً ۳ میلیارد پارامتر فعال میشود. پارامترهای غیرفعال همچنان باید در حافظه رم یا VRAM نگهداری شوند، اما در هر گام محاسباتی بهطور کامل پردازش نمیشوند.
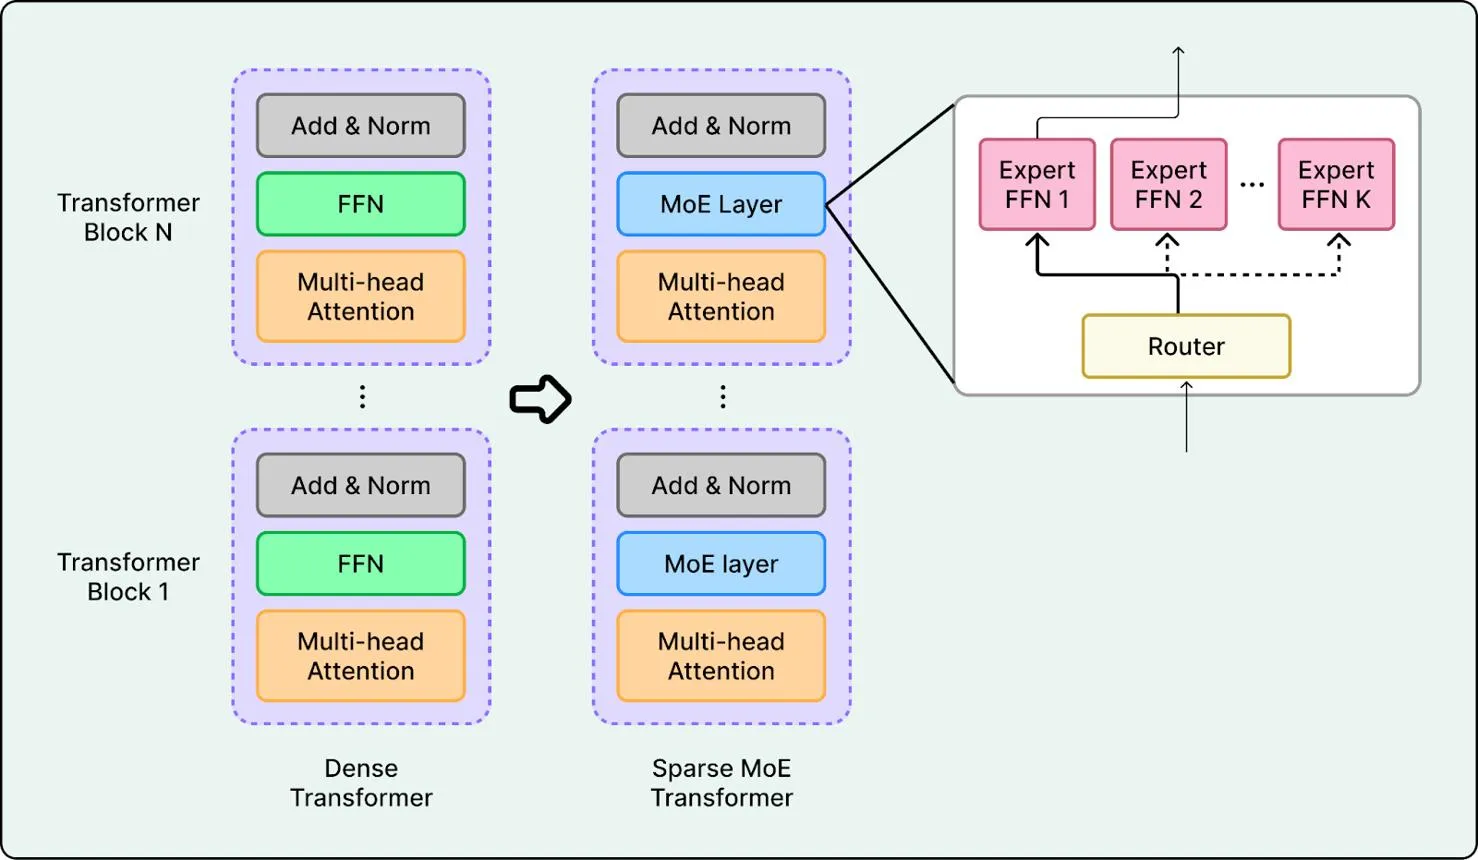
در یک سیستم با VRAM محدود میتوان بخشی از اجزای پرتکرار و متخصصهای فعال را روی کارت گرافیک نگه داشت و سایر وزنها را در رم سیستم قرار داد. این کار ممکن است اجرای مدلهای بزرگتری را امکانپذیر کند، بدون آنکه سرعت به اندازه برخی مدلهای متراکم با حجم مشابه افت کند.
با این حال، معماری MoE محدودیت حافظه را کاملاً از بین نمیبرد. همه وزنهای مدل باید جایی در حافظه قرار بگیرند و اگر رم کافی نباشد، سیستم به مشکل میخورد. همچنین سرعت حافظه رم، پهنای باند PCIe، نحوه پیادهسازی مدل و تنظیمات موتور استنتاج روی نتیجه نهایی اثر دارند.
اجرای مدلهای MoE با کارت گرافیک RTX 3080 Ti و GTX 1080
در یک نمونه عملی، کارت گرافیک RTX 3080 Ti با ۱۲ گیگابایت VRAM و سیستم مجهز به ۳۲ گیگابایت رم، برای اجرای مدل Qwen3.6-35B-A3B استفاده شده است. با تنظیمات مشخص در llama.cpp و قرار دادن ۲۵ لایه روی GPU، سرعت گزارششده به حدود ۲۴ توکن در ثانیه رسیده است. این نتیجه نشان میدهد که حتی کارت گرافیکی با حافظه محدود نیز میتواند در شرایط مناسب از یک مدل MoE نسبتاً بزرگ استفاده کند.
نمونه دیگر، کارت GTX 1080 با ۸ گیگابایت VRAM است. این کارت فاقد هستههای Tensor نسلهای جدید انویدیا است، اما در سیستمی با حدود ۳۲ گیگابایت رم DDR4 توانسته مدل Gemma-4-26B-A4B را با سرعت گزارششده حدود ۱۴ توکن در ثانیه اجرا کند.
این اعداد به یک پیکربندی مشخص مربوطاند و تضمینی برای رسیدن به همان سرعت روی همه کامپیوترها نیستند. نسخه مدل، نوع کوانتیزهسازی، تعداد لایههای منتقلشده به GPU، طول متن ورودی و تنظیمات نرمافزار میتوانند عملکرد را تغییر دهند. به همین دلیل، هنگام مقایسه دو سیستم باید از مدل و تنظیمات یکسان استفاده کرد.
نکته مهم دیگر این است که سرعت تولید توکن تنها معیار عملکرد نیست. تأخیر اولیه در تولید پاسخ، زمان پردازش درخواستهای طولانی و میزان حافظه مصرفشده نیز در تجربه استفاده از مدل اهمیت دارند؛ بهخصوص زمانی که مدل برای برنامهنویسی یا ابزارهای بهرهوری به کار میرود.
استفاده از مدلهای MoE برای برنامهنویسی و ابزارهای هوش مصنوعی محلی
مدلهای MoE میتوانند در ابزارهای بهرهوری و برنامهنویسی محلی نیز کاربرد داشته باشند. برای مثال، یک مدل زبانی اجراشده روی کامپیوتر شخصی میتواند در محیط توسعه کد پیشنهاد دهد، خطاهای برنامه را بررسی کند یا به تحلیل مشکلات پروژه کمک کند. در این حالت، اطلاعات پروژه میتوانند بهجای ارسال به یک سرویس ابری، روی زیرساخت محلی پردازش شوند؛ البته میزان حفظ حریم خصوصی به تنظیمات و نحوه اتصال سایر ابزارها نیز بستگی دارد.
از جمله ابزارهایی که میتوان با مدلهای محلی ترکیب کرد، این موارد هستند:
- VS Code: برای کمک به تکمیل کد و پاسخگویی به پرسشهای برنامهنویسی با اتصال به یک مدل محلی.
- Perplexica یا Vane: برای ساخت تجربه جستوجو و پاسخگویی مبتنی بر هوش مصنوعی؛ قابلیت جستوجوی وب به تنظیمات و دسترسی شبکه وابسته است.
- Open Notebook: برای سازماندهی یادداشتها و استفاده از قابلیتهای هوش مصنوعی در کار با اطلاعات.
- Paperless-GPT: برای افزودن قابلیتهای هوش مصنوعی به فرایند پردازش و کار با اسناد در کنار سامانه Paperless-ngx.
- Blinko: برای مدیریت یادداشتها و اطلاعات شخصی با قابلیتهای مرتبط با هوش مصنوعی، بسته به پیکربندی.
برای استفاده از این ابزارها، تنها داشتن کارت گرافیک کافی نیست. باید مدل موردنظر با موتور استنتاج و ابزار انتخابی سازگار باشد و حافظه رم و فضای ذخیرهسازی نیز پاسخگوی نیاز آن باشند. اگر قصد اجرای مدلهای بزرگ را دارید، بهتر است پیش از دانلود، حجم فایل مدل و مقدار حافظه موردنیاز برای نسخه کوانتیزهشده را بررسی کنید.
در مجموع، معماری MoE راهی برای استفاده از مدلهای زبانی بزرگتر روی سختافزارهای محدود فراهم میکند. این معماری بهخصوص برای کسانی مفید است که میخواهند هوش مصنوعی را بهصورت محلی اجرا کنند و بدون خرید کارت گرافیک گرانقیمت، از مدلهای قدرتمندتر برای برنامهنویسی و کارهای روزمره کمک بگیرند. البته مقدار رم، سرعت حافظه و تنظیمات استنتاج همچنان تعیین میکنند که تجربه نهایی تا چه اندازه روان باشد.
گیم پلنت