اجرای مدلهای زبانی بزرگ روی کامپیوتر دیگر به کارت گرافیک چنددهگیگابایتی یا سیستمهای گرانقیمت محدود نیست. مدلهای کوچک هوش مصنوعی (SLM) با تعداد پارامتر کمتر و نسخههای فشردهشده، روی لپتاپهای معمولی و حتی بعضی سیستمهای بدون کارت گرافیک مجزا هم اجرا میشوند. البته کوچک بودن مدل بهتنهایی به معنی پاسخهای باکیفیت نیست؛ باید بین مصرف حافظه، سرعت پاسخگویی و توانایی مدل در نوشتن، برنامهنویسی و استدلال تعادل برقرار کنید.
بهترین مدلهای هوش مصنوعی کوچک برای اجرا به صورت محلی
برای اجرای هوش مصنوعی محلی، مدلهایی با حدود یک تا چهار میلیارد پارامتر نقطه شروع مناسبی هستند. این مدلها معمولاً برای گفتوگوی روزمره، خلاصهسازی، بازنویسی متن، ترجمه و بعضی کارهای برنامهنویسی سبک کاربرد دارند. مدلهای کوچکتر حافظه کمتری مصرف میکنند، اما در دستورهای پیچیده و پاسخهای چندمرحلهای معمولاً محدودتر هستند.
در میان گزینههای شناختهشده، خانوادههای Qwen، Gemma، Llama و Phi انتخابهای قابلتوجهی هستند. نسخه دقیق مدل، روش فشردهسازی و طول متن ورودی میتوانند مصرف حافظه را به شکل محسوسی تغییر دهند.
Qwen3؛ مدل کوچک و چندمنظوره برای کارهای روزمره
Qwen3 در اندازههای مختلف عرضه شده و نسخههای کوچک آن برای اجرای محلی جذاب هستند. مدل Qwen3 0.6B برای کارهای ساده و پاسخهای کوتاه مناسب است؛ نسخه ۱.۷B توانایی بیشتری در دنبال کردن دستورها دارد و Qwen3 4B گزینه متعادلتری برای گفتوگو، خلاصهسازی و کارهای چندزبانه محسوب میشود.
اگر حافظه سیستم محدود است، نسخههای ۰.۶B و ۱.۷B ارزش امتحان کردن دارند. اما اگر کیفیت پاسخ اهمیت بیشتری دارد و منابع سختافزاری کافی در اختیار دارید، نسخه 4B انتخاب منطقیتری است.
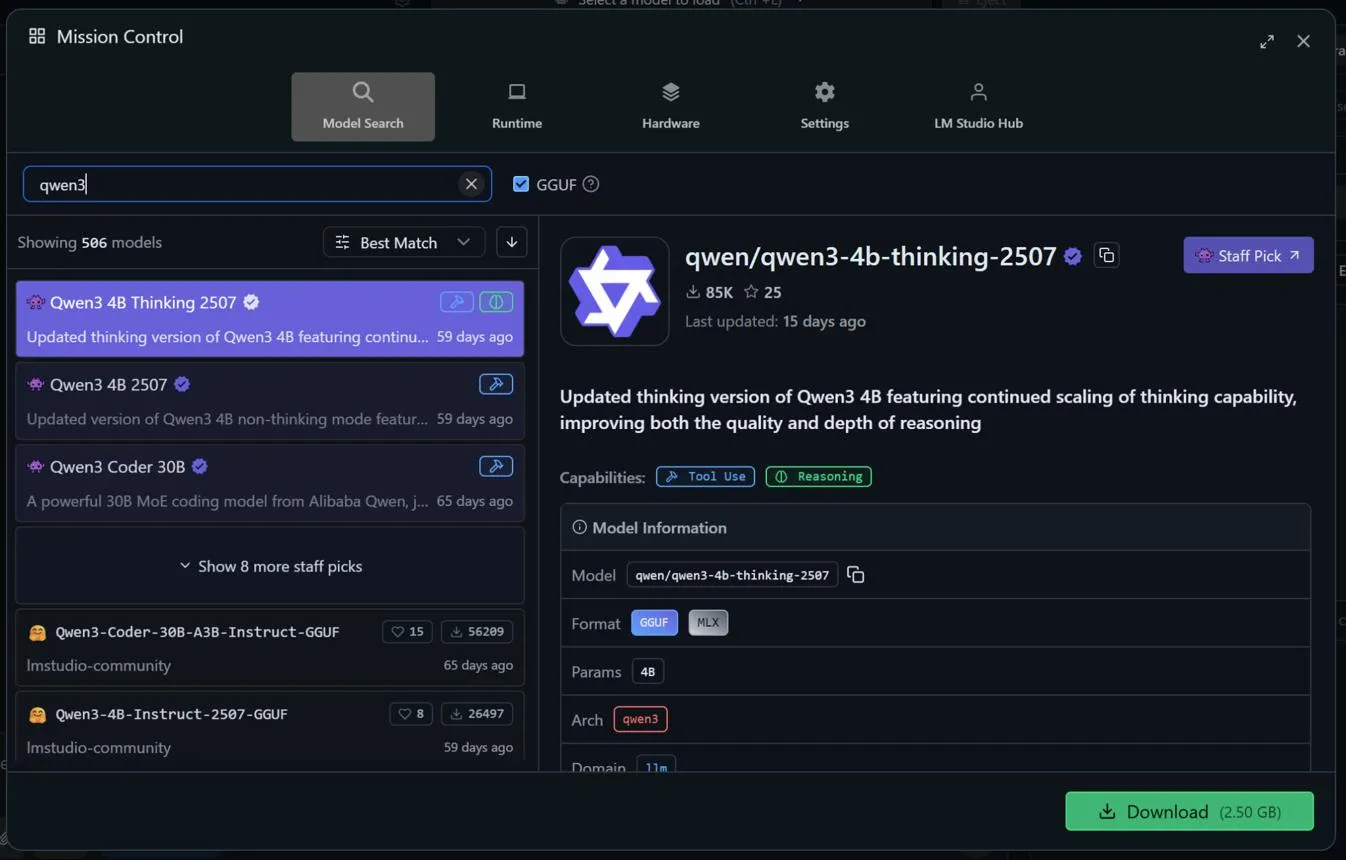
Llama 3.2 3B؛ مدل سبک متا برای گفتوگو و تولید متن
Llama 3.2 3B یکی از گزینههای شناختهشده برای اجرای آفلاین است. این مدل با حدود سه میلیارد پارامتر، برای چتباتهای سبک، پاسخ به پرسشهای عمومی و بازنویسی متن طراحی شده است.
نسخه فشردهشده چهار بیتی آن به فضای نسبتاً کمی نیاز دارد و در مقایسه با مدلهای بزرگتر راحتتر اجرا میشود. با این حال، برای تحلیلهای طولانی، کدنویسی پیچیده یا استدلالهای چندمرحلهای نباید انتظار عملکرد مدلهای بزرگ را از آن داشت.
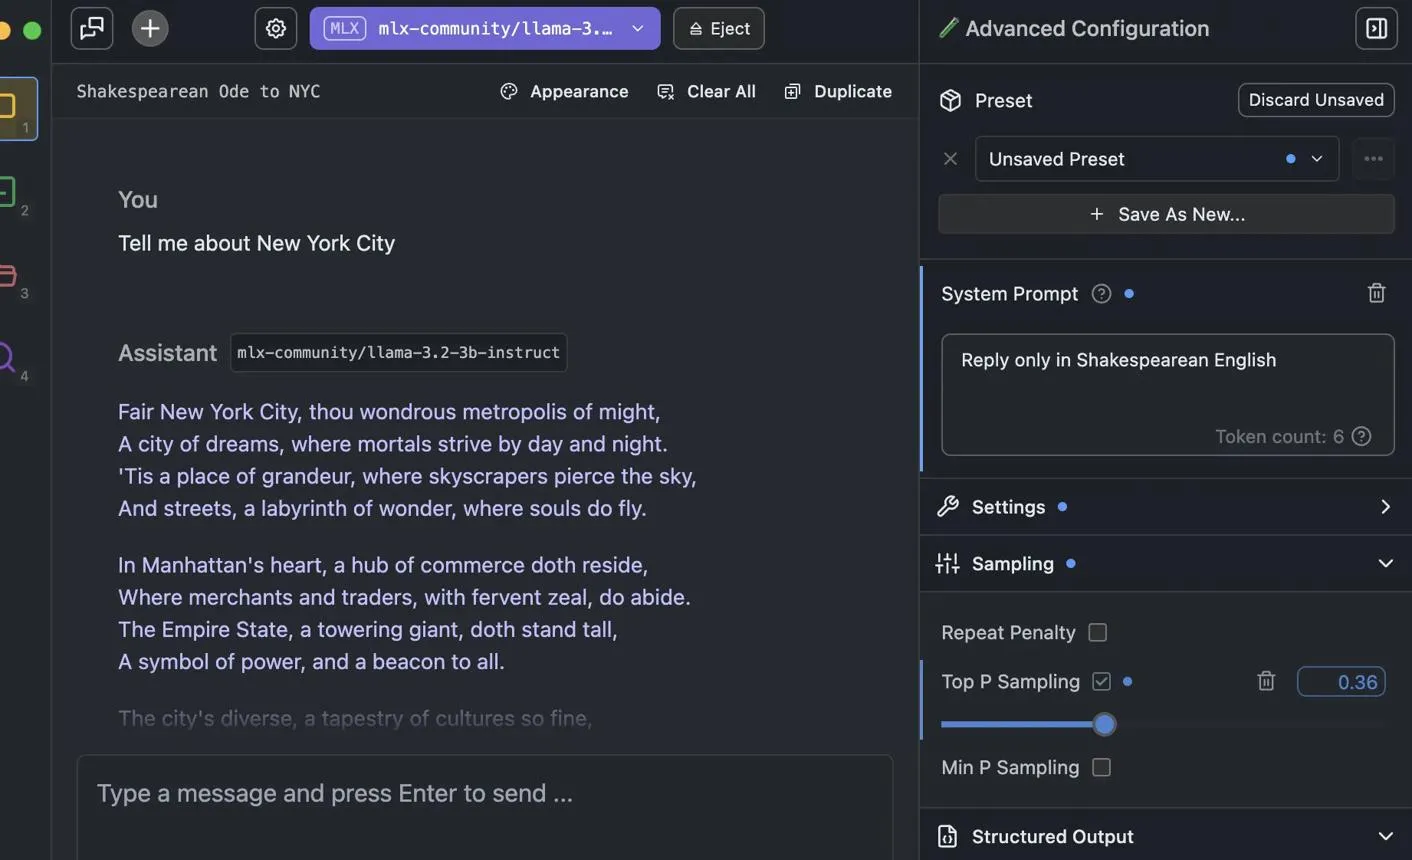
Gemma؛ مدل کوچک گوگل با نسخههای مناسب سیستمهای ضعیف
Gemma برای کاربرانی که به دنبال مدلهای سبک با توانایی تولید متن و پاسخگویی هستند، گزینه دیگری است. نسخههای کوچک این خانواده در اندازههای مختلف عرضه شدهاند و انتخاب مدل باید با توجه به حافظه و نوع کاربرد انجام شود.
مدلهای کوچکتر Gemma برای پاسخهای کوتاه و پردازشهای ساده مناسباند؛ نسخههای بزرگتر توانایی بیشتری دارند، اما حافظه بیشتری هم مصرف میکنند. برخی نسخههای این خانواده قابلیت دریافت تصویر نیز دارند؛ بنابراین در صورت نیاز به تحلیل محتوای تصویری باید مشخصات همان نسخه را بررسی کنید.
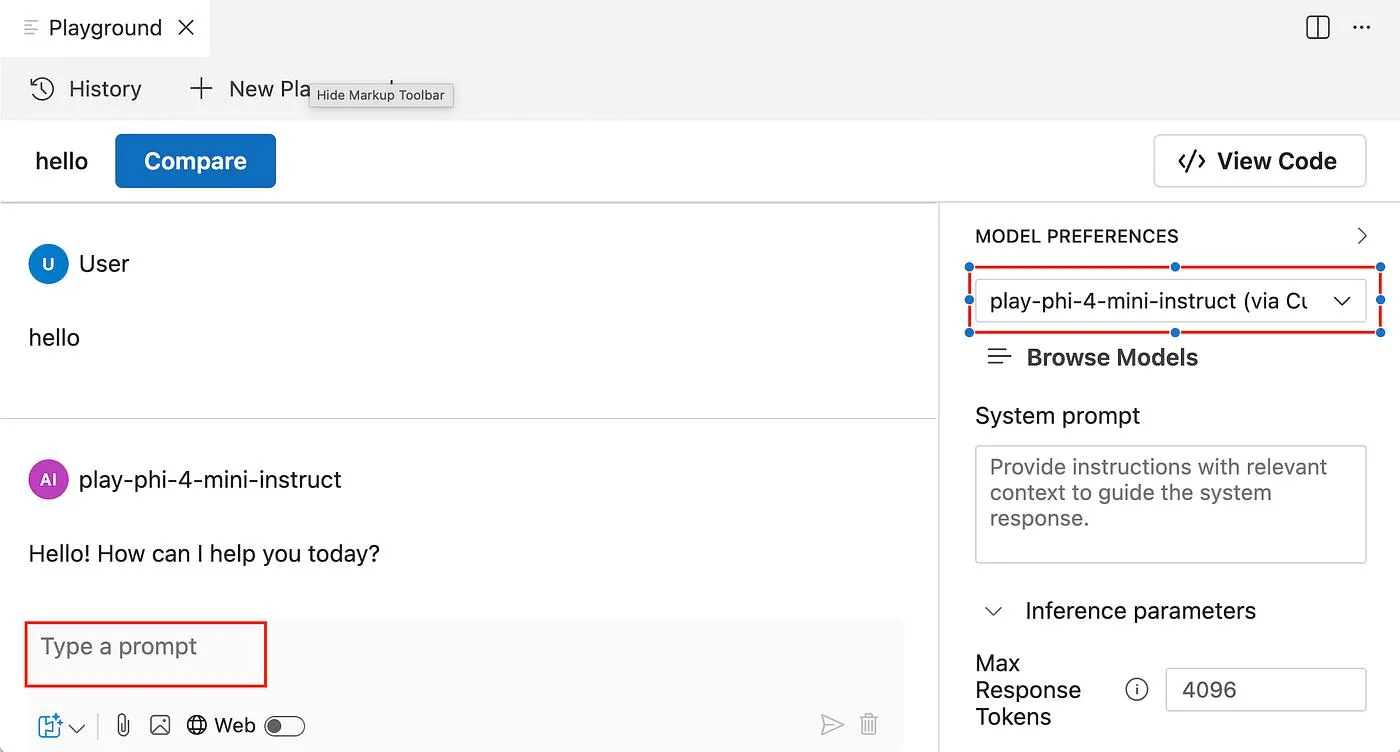
Phi-4 Mini؛ مدل کوچک مایکروسافت برای استدلال و کدنویسی
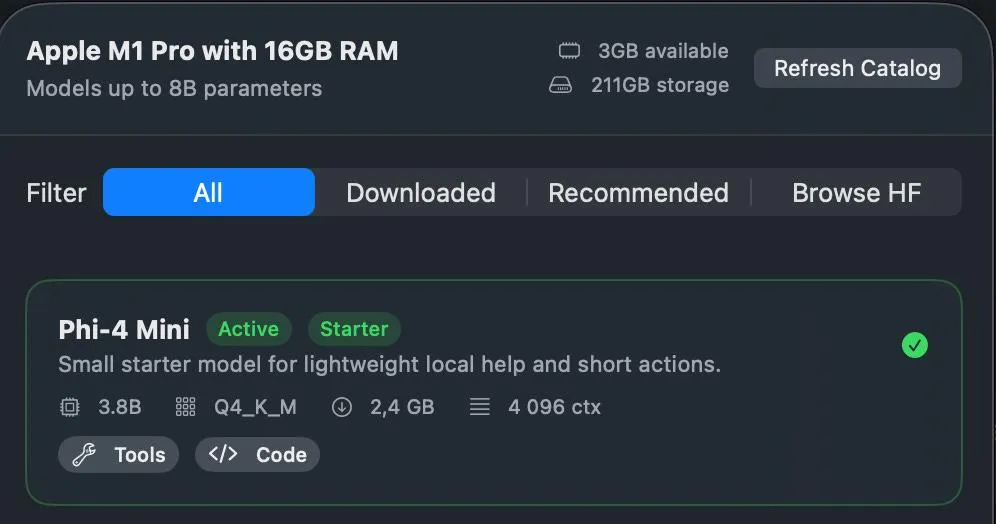
Phi-4-mini با حدود ۳.۸ میلیارد پارامتر، یکی از مدلهایی است که برای سیستمهای دارای منابع محدود طراحی شده است. این مدل روی استدلال، ریاضی، کدنویسی و اجرای دستورهای متنی تمرکز دارد و از پنجره متنی تا ۱۲۸ هزار توکن پشتیبانی میکند.
نسخه فشرده چهار بیتی آن میتواند انتخاب مناسبی برای کامپیوترهایی باشد که حافظه گرافیکی محدودی دارند. البته پشتیبانی از پنجره متنی بزرگ به معنی اجرای بدون محدودیت نیست؛ هرچه متن ورودی و تاریخچه گفتوگو طولانیتر شود، حافظه بیشتری برای پردازش لازم خواهد بود.
مدلهای بسیار کوچک هوش مصنوعی برای کامپیوترهای ضعیف
اگر سیستم شما رم یا حافظه گرافیکی محدودی دارد، بهتر است بهجای شروع با مدلهای چهار یا هفت میلیارد پارامتری، سراغ مدلهای زیر دو میلیارد پارامتر بروید. این مدلها برای کارهای ساده مناسباند و میتوانند بدون نیاز به سختافزار قدرتمند، تجربه اجرای هوش مصنوعی محلی را فراهم کنند.
|
مدل |
کاربرد مناسب |
|---|---|
|
Qwen3 0.6B |
پاسخهای کوتاه و پردازش متن ساده |
|
Gemma 3 1B |
گفتوگوی سبک و تولید متن کوتاه |
|
Qwen3 1.7B |
دنبال کردن دستورها و پرسشوپاسخ |
|
Llama 3.2 1B |
چتبات ساده و پردازش متنی |
این مدلها برای جایگزینی کامل سرویسهای هوش مصنوعی قدرتمند ساخته نشدهاند. اگر به تحلیل دقیق، برنامهنویسی جدی یا بررسی اسناد طولانی نیاز دارید، بهتر است مدل بزرگتری انتخاب کنید.
برای اجرای مدل هوش مصنوعی محلی چقدر رم و حافظه گرافیکی نیاز داریم؟
میزان حافظه موردنیاز فقط به تعداد پارامترهای مدل وابسته نیست. نوع فشردهسازی، طول متن ورودی، اندازه پاسخ و نرمافزار اجراکننده هم بر مصرف منابع اثر میگذارند. به همین دلیل ممکن است دو نسخه از یک مدل، با وجود نام یکسان، مصرف حافظه متفاوتی داشته باشند.
بهصورت تقریبی، وزن مدلهای فشردهشده چهار بیتی چنین فضایی اشغال میکند:
- مدلهای ۰.۵ تا ۱ میلیارد پارامتری: حدود ۰.۵ تا ۱ گیگابایت
- مدلهای ۱.۵ تا ۲ میلیارد پارامتری: حدود ۱ تا ۱.۷ گیگابایت
- مدلهای ۳ تا ۴ میلیارد پارامتری: حدود ۲ تا ۳.۵ گیگابایت
- مدلهای ۷ تا ۸ میلیارد پارامتری: حدود ۴ تا ۵.۵ گیگابایت
این اعداد فقط تخمین حجم وزن مدل هستند و حافظه لازم برای اجرای برنامه، پردازش متن و نگهداری تاریخچه گفتوگو را شامل نمیشوند. بنابراین برای اجرای روان باید مقداری حافظه آزاد بیشتر در نظر بگیرید.
تفاوت نسخههای Q4 و Q8 در مدلهای هوش مصنوعی
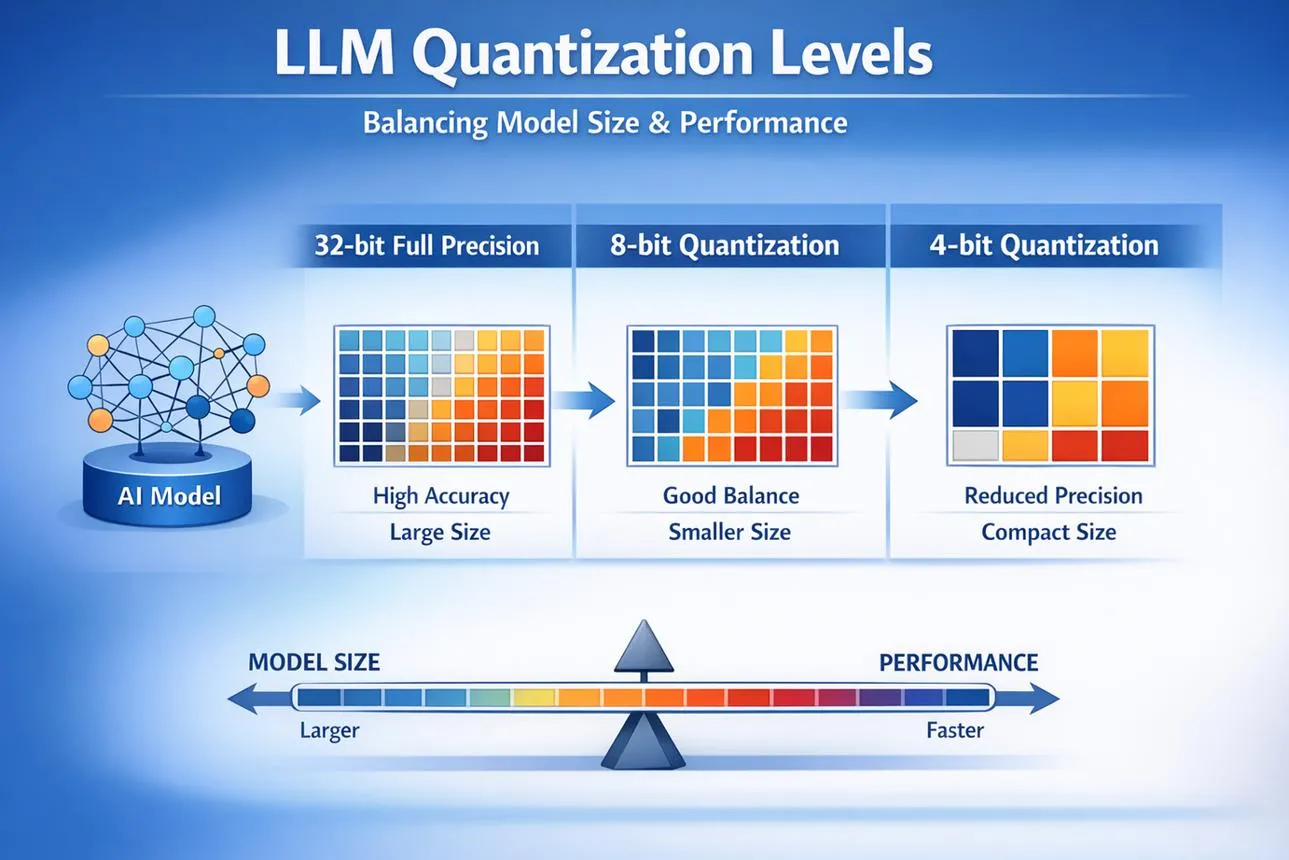
هنگام دانلود مدل محلی ممکن است با عبارتهایی مانند Q4_K_M و Q8 روبهرو شوید. این عبارتها به روش کوانتیزهسازی یا کاهش دقت اعداد مدل اشاره دارند.
- Q4: وزنهای مدل با دقت کمتر ذخیره میشوند و معمولاً حافظه کمتری مصرف میکنند. این نسخه برای سیستمهای محدود مناسب است.
- Q8: دقت عددی بیشتری حفظ میشود و معمولاً کیفیت خروجی به نسخه اصلی نزدیکتر است؛ اما فضای بیشتری نیاز دارد.
- FP16: دقت بالاتری دارد، ولی حافظه بیشتری مصرف میکند و برای سیستمهای ضعیف همیشه انتخاب مناسبی نیست.
برای شروع، نسخه Q4 معمولاً انتخاب اقتصادیتری است. اگر حافظه کافی دارید و کیفیت پاسخ برایتان اهمیت بیشتری دارد، میتوانید نسخه Q8 را هم آزمایش کنید.
اجرای مدلهای کوچک با Ollama و LM Studio
برای اجرای هوش مصنوعی محلی نیازی نیست حتماً محیط برنامهنویسی پیچیدهای نصب کنید. دو نرمافزار شناختهشده به نامهای Ollama و LM Studio این کار را سادهتر میکنند.
Ollama برای اجرای مدلها از طریق ترمینال و اتصال آنها به برنامههای دیگر مناسب است. پس از نصب، میتوانید مدل موردنظر را با دستور مربوط به آن دریافت و اجرا کنید.
به عنوان مثال، برای اجرای یک مدل سبک Qwen در نسخههای پشتیبانیشده Ollama میتوانید از دستور زیر استفاده کنید:
ollama run qwen3:0.6b
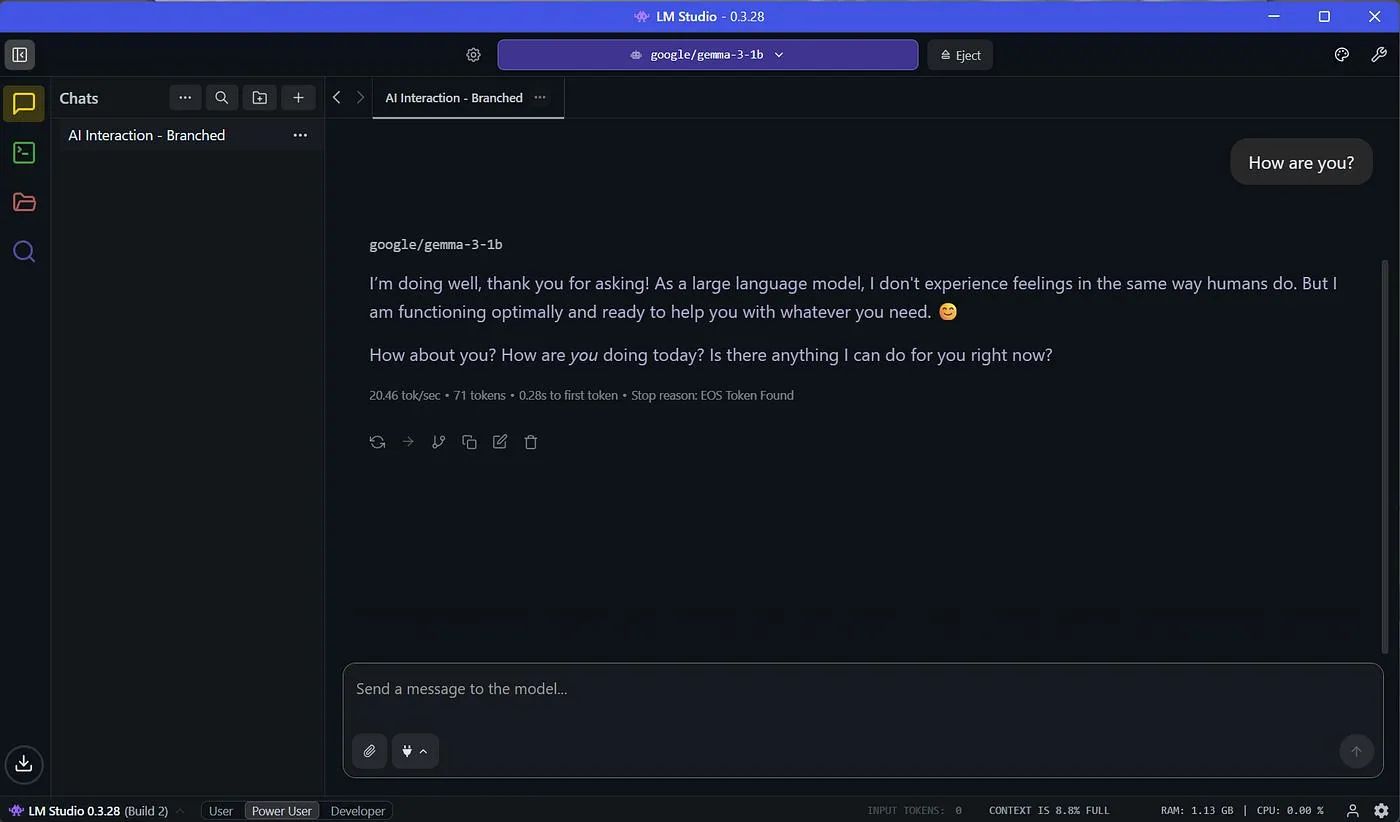
در مقابل، LM Studio محیط گرافیکی دارد و به شما اجازه میدهد مدلهای سازگار را جستوجو کنید، دانلود کنید و بدون کار با دستورات ترمینال اجرا کنید. این برنامه برای افرادی که تازه وارد دنیای هوش مصنوعی محلی شدهاند، سادهتر است.
کدام مدل کوچک هوش مصنوعی را انتخاب کنیم؟
انتخاب بهترین مدل به نوع کار و سختافزار شما بستگی دارد. اگر فقط به یک چتبات ساده برای پرسشهای کوتاه نیاز دارید، مدلهای زیر دو میلیارد پارامتر کافی هستند. برای نوشتن متن، ترجمه و خلاصهسازی بهتر است سراغ مدلهای سه تا چهار میلیارد پارامتری بروید.
- برای سیستمهای بسیار ضعیف: Qwen3 0.6B یا Gemma 3 1B را امتحان کنید.
- برای گفتوگو و تولید متن: Llama 3.2 3B یا Qwen3 4B انتخابهای مناسبی هستند.
- برای ریاضی و کدنویسی سبک: Phi-4 Mini ارزش آزمایش دارد.
- برای کارهای چندزبانه: Qwen3 4B گزینه قابلتوجهی است.
پیشنهاد میشود پیش از دانلود مدلهای بزرگ، ابتدا نسخه Q4 مدلهای کوچک را امتحان کنید و سرعت تولید متن، میزان مصرف رم و کیفیت پاسخها را روی سیستم خود بسنجید. در نهایت، مدلی مناسبتر است که بدون پر شدن حافظه و کند شدن شدید کامپیوتر، وظایف موردنیاز شما را بهدرستی انجام دهد.
گیم پلنت