اجرای یک مدل زبانی محلی روی کامپیوتر فقط به چت کردن و تولید متن محدود نیست. با ترکیب یک ابزار عاملمحور مانند OpenCode و یک سرویس اجرای مدل مانند LM Studio میتوانید بخشی از کارهای روزمره را بدون مصرف سهمیه سرویسهای ابری انجام دهید؛ کارهایی مانند بررسی فایلها، جستوجوی یادداشتها، توضیح ساختار پروژه و ویرایش تغییرات کوچک.
این روش بهخصوص زمانی مفید است که نمیخواهید برای کارهای ساده از مدلهای قدرتمندی مانند Claude استفاده کنید. البته مدل محلی قرار نیست در تمام پروژهها جایگزین مدلهای ابری شود؛ محدودیت حافظه گرافیکی، طول کانتکست و توانایی مدل در استفاده از ابزارها همچنان اهمیت زیادی دارد.
اجرای مدل هوش مصنوعی محلی در OpenCode با LM Studio
OpenCode یک عامل کدنویسی با قابلیت کار روی فایلها و پروژههای کامپیوتری است. برخلاف چتباتهایی که صرفاً به پرسشها پاسخ میدهند، این ابزار میتواند با کمک مدل انتخابشده، فایلها را جستوجو کند، محتوای آنها را بخواند و تغییرات پیشنهادی را اعمال کند.
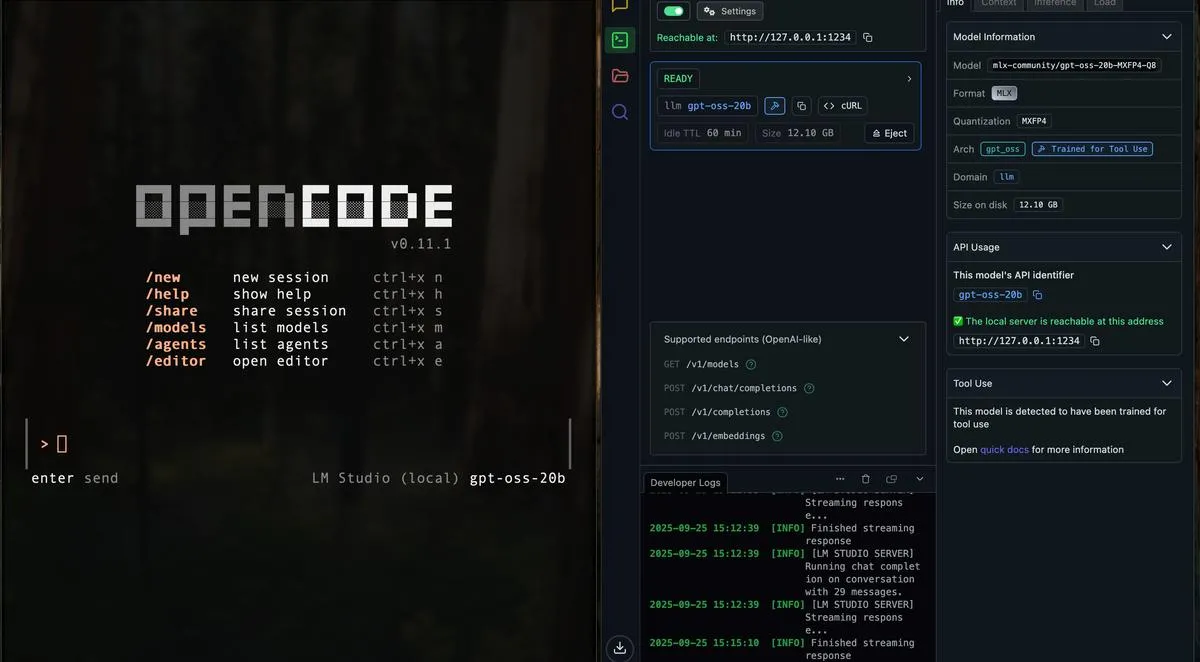
برای استفاده از مدل محلی، میتوانید OpenCode را به یکی از سرویسهای اجرای مدل مانند LM Studio یا Ollama متصل کنید. OpenCode مدلهای موجود در این سرویسها را در آدرسهای پیشفرض شناسایی میکند و امکان انتخاب آنها را در فهرست مدلها فراهم میسازد.
در این روش، ابتدا مدل را در LM Studio اجرا کنید:
- برنامه LM Studio را باز کنید و وارد بخش Developer شوید.
- در قسمت Local Server، سرور محلی را روشن کنید.
- به بخش Chat یا انتخاب مدل بروید و مدل موردنظر را بارگذاری کنید.
- مقدار Context Length را متناسب با حافظه سیستم تنظیم کنید.
- برنامه OpenCode را اجرا کنید و از بخش انتخاب مدل، مدل شناساییشده در LM Studio را انتخاب کنید.
LM Studio → Developer → Local Server
الام استودیو ← توسعهدهنده ← سرور محلی
یکی از مدلهایی که میتوان برای این نوع کارها بررسی کرد Qwen 3.5 9B است. نسخههای کوانتایزشده مانند Q4_K_M حجم کمتری دارند و برای اجرای محلی مناسبتر هستند؛ البته میزان حافظه موردنیاز فقط به حجم فایل مدل وابسته نیست و طول کانتکست و تنظیمات اجرای آن نیز مصرف VRAM را تغییر میدهند.
در کنار Qwen میتوانید مدلهای دیگری را هم امتحان کنید؛ اما برای کار با OpenCode صرفاً توانایی تولید کد کافی نیست. مدل باید بتواند درخواست استفاده از ابزارها را درست تشخیص دهد و فرمانهای مربوط به خواندن یا ویرایش فایلها را به شکل صحیح صادر کند. در LM Studio مدلهایی که پشتیبانی بومی از Tool Use دارند معمولاً انتخاب مناسبتری هستند.
بررسی و جستوجوی فایلها با مدل زبانی محلی در OpenCode
یکی از کاربردهای مهم OpenCode بررسی فایلهای یک پروژه یا فولدر کاری است. میتوانید از مدل بخواهید فایلهای یک فولدر را بررسی کند، کاربرد هر فایل را توضیح دهد یا یادداشتهایی را پیدا کند که موضوع مشترکی دارند.
به عنوان مثال، اگر یک فولدر شامل یادداشتهای متنی دارید، میتوانید از مدل بخواهید فایلهایی را که برچسب مشخصی ندارند پیدا کند. OpenCode با استفاده از ابزارهای جستوجو و خواندن فایلها، اطلاعات را در اختیار مدل قرار میدهد تا نتیجه را تحلیل کند.
با این حال، تعداد فایلهایی که مدل میتواند بررسی کند به محدودیت کانتکست بستگی دارد. محتوای هر فایلی که خوانده میشود بخشی از فضای مکالمه را مصرف میکند. اگر تعداد فایلها زیاد باشد، ممکن است کانتکست پر شود و ابزار مجبور شود مکالمه را خلاصهسازی کند. در چنین شرایطی، مدل ممکن است جزئیات بررسیهای قبلی را از دست بدهد یا بعضی فایلها را دوباره بخواند.
برای جلوگیری از این مشکل، بهتر است بررسی فایلها را محدود و هدفمند انجام دهید:
- به جای درخواست بررسی یک فولدر بزرگ، ابتدا یک زیرشاخه کوچک را انتخاب کنید.
- از مدل بخواهید فقط فایلهای مرتبط با موضوع موردنظر را باز کند.
- برای هر کار مستقل، یک نشست جدید ایجاد کنید تا اطلاعات غیرضروری وارد کانتکست نشود.
- در درخواست خود مشخص کنید که مدل باید نام فایلها و نتیجه بررسی را گزارش کند و سراغ فایلهای نامرتبط نرود.
این روش برای بررسی پروژههای کوچک، مرتبسازی یادداشتها و شناخت ساختار یک کدبیس ساده کاربردی است؛ اما بررسی همزمان صدها فایل با یک مدل کوچک ممکن است نتیجه قابلاعتمادی نداشته باشد.
ویرایش فایلها با OpenCode و مدل هوش مصنوعی آفلاین
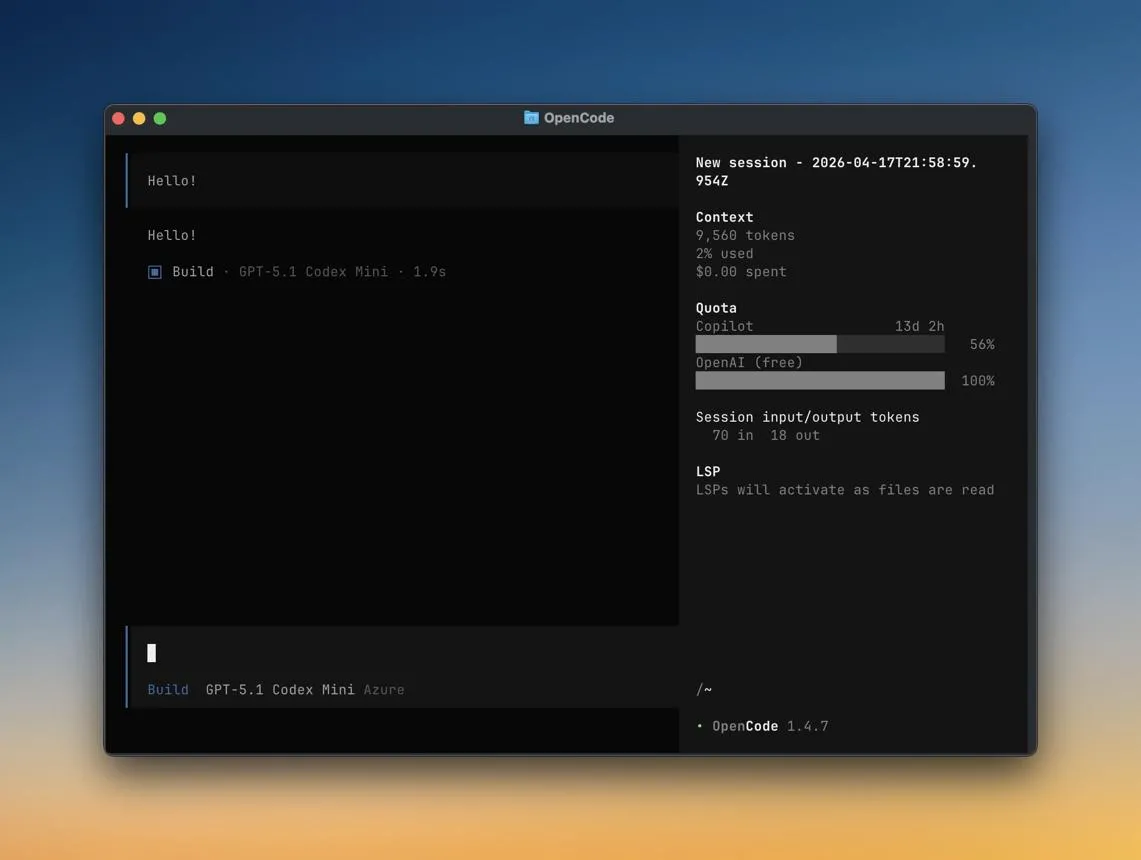
OpenCode علاوه بر خواندن فایلها، میتواند با کمک مدل محلی تغییرات مشخصی را نیز اعمال کند. این قابلیت برای کارهای تکراری و کمریسک مانند افزودن برچسب به یادداشتها، اصلاح نام یک دکمه یا تغییر متن در چند فایل محدود مفید است.
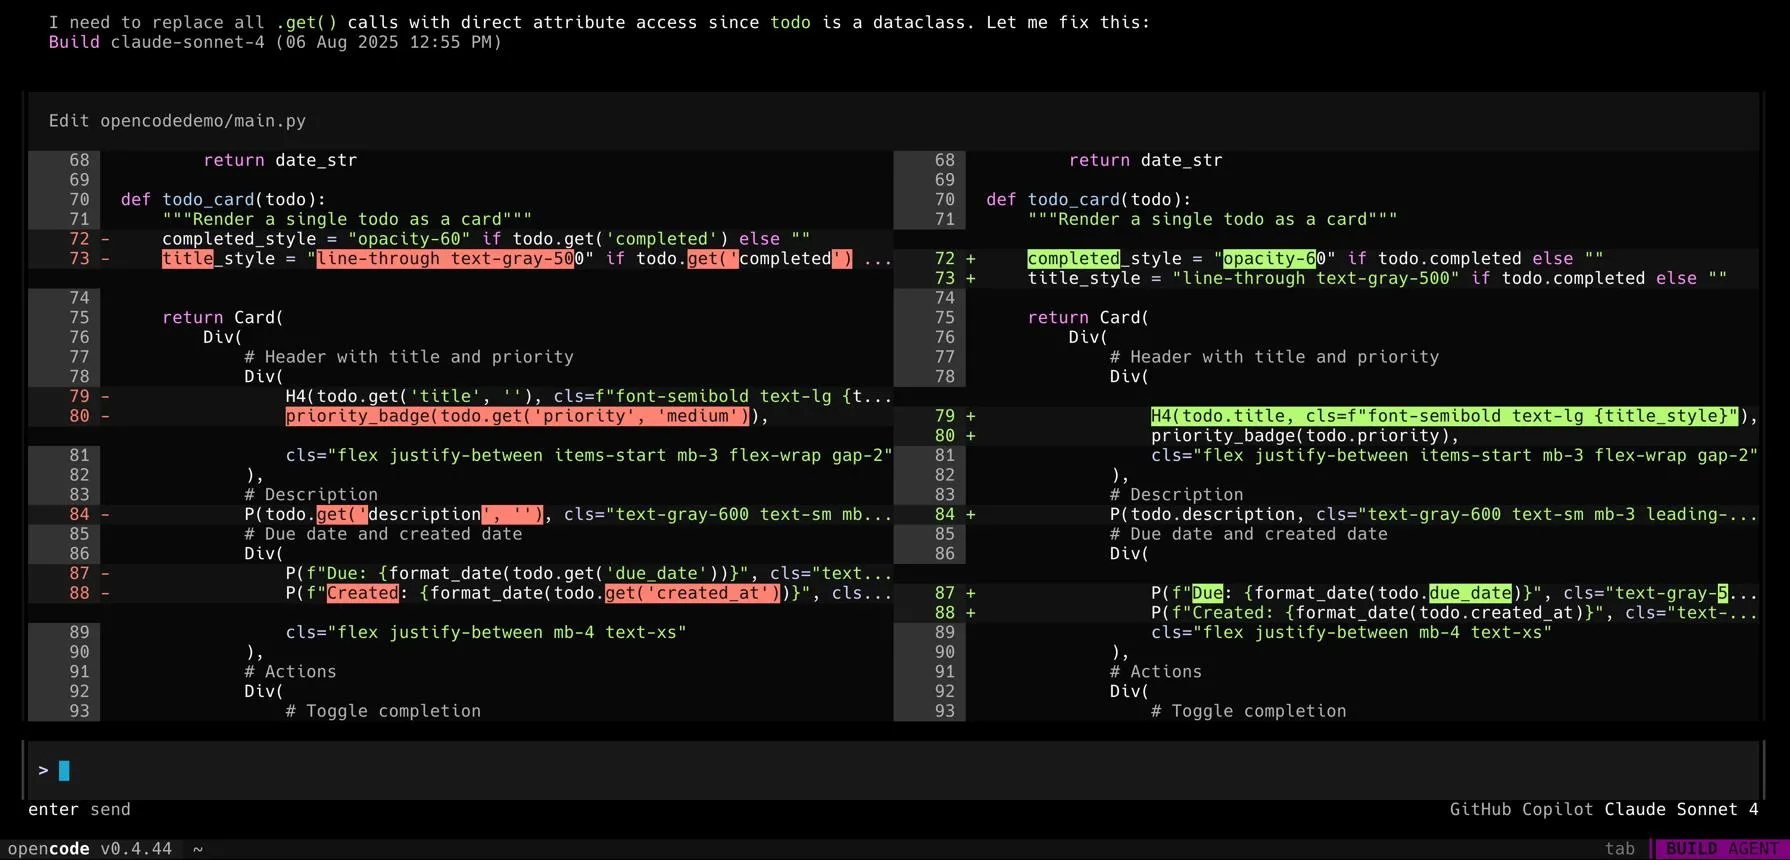
یکی از ویژگیهای کاربردی این ابزار نمایش تفاوت میان نسخه قبلی و جدید فایل است. به این ترتیب میتوانید تغییرات اعمالشده را بررسی کنید و ببینید مدل دقیقاً کدام خطوط را تغییر داده است.
OpenCode همچنین قابلیت Snapshot دارد که به صورت پیشفرض فعال است و امکان بازگردانی برخی تغییرات فایلها را در همان نشست فراهم میکند. البته این قابلیت جایگزین نسخه پشتیبان یا Git نیست؛ برای استفاده از بازگردانی فایلها، پروژه باید در یک مخزن Git قرار داشته باشد و همه تغییرات خارج از محدوده ثبتشده نیز لزوماً قابل بازگردانی نیستند.
برای اینکه مدل فقط تغییرات موردنظر را انجام دهد، درخواست را دقیق بنویسید. به عنوان مثال، به جای اینکه بگویید «فایلها را مرتب کن»، مشخص کنید کدام فایلها باید تغییر کنند، چه برچسبی باید اضافه شود و چه بخشهایی نباید دستکاری شوند.
یک نکته مهم نیز به قالببندی فایلها مربوط است. مدلهای کوچک ممکن است دستور را درست اجرا کنند اما ساختار یا Syntax نامعتبر تولید کنند. به همین دلیل، بعد از هر ویرایش فایل را در نرمافزاری که برای باز کردن آن طراحی شده است بررسی کنید. در پروژههای برنامهنویسی نیز اجرای تستها و بررسی خطاهای احتمالی ضروری است.
محدودیت مدلهای محلی با کارت گرافیک ۸ گیگابایتی و تفاوت آنها با Claude
اجرای مدل محلی با کارت گرافیک ۸ گیگابایتی برای بعضی کارهای ساده امکانپذیر است؛ اما نباید انتظار داشته باشید تمام وظایف یک مدل ابری قدرتمند را با همان کیفیت انجام دهد. در این شرایط، مدلهای 9B کوانتایزشده میتوانند برای کارهای محدود مفید باشند، ولی هنگام بررسی تعداد زیادی فایل یا اجرای نشستهای طولانی با محدودیت روبهرو میشوند.
سه عامل اصلی روی عملکرد مدل تأثیر میگذارند:
- حافظه VRAM: بخشی از حافظه گرافیکی برای بارگذاری وزنهای مدل و بخش دیگری برای پردازش و نگهداری اطلاعات موردنیاز مصرف میشود. بنابراین مدل 9B با کوانتایز Q4_K_M ممکن است در برخی تنظیمات روی کارت ۸ گیگابایتی اجرا شود، اما فضای کافی برای کانتکست بزرگ باقی نماند.
- طول کانتکست: هرچه تعداد فایلهای خواندهشده و متن مکالمه بیشتر باشد، فضای بیشتری از کانتکست اشغال میشود. افزایش این مقدار نیز میتواند مصرف حافظه را بالا ببرد.
- قابلیت استفاده از ابزارها: مدل باید بتواند فرمانهای مربوط به جستوجو و ویرایش فایلها را درست اجرا کند. یک مدل با توانایی مکالمه خوب لزوماً عامل مناسبی برای کار با فایلها نیست.
برای مدیریت بهتر منابع، لازم نیست همیشه کانتکست را روی بیشترین مقدار ممکن قرار دهید. در LM Studio میتوانید هنگام بارگذاری مدل، طول کانتکست و میزان استفاده از GPU را تنظیم کنید و پیش از اجرای مدل نیز تخمین حافظه موردنیاز را ببینید.
در نهایت، بهتر است کارها را بین مدل محلی و سرویس ابری تقسیم کنید. بررسی فولدرهای کوچک، توضیح فایلها، افزودن برچسب و اصلاحات محدود را به OpenCode و مدل محلی بسپارید؛ اما برای پروژههای بزرگ، تحلیل پیچیده و تغییرات حساس از Claude یا مدلهای ابری قدرتمندتر کمک بگیرید.
این ترکیب باعث میشود سهمیه مدلهای ابری برای کارهایی باقی بماند که واقعاً به توان پردازشی و استدلال بیشتری نیاز دارند. مدل محلی قرار نیست Claude را کاملاً کنار بزند؛ هدف این است که کارهای ساده و تکراری، منابع و سهمیه سرویسهای گرانتر را مصرف نکنند.
گیم پلنت