هوش مصنوعی

اجرای هوش مصنوعی محلی با گرافیک مجتمع؛ بنچمارک AMD Ryzen و Radeon

اجرای مدل‌های زبانی بزرگ به‌صورت محلی روی رایانه، دیگر فقط به کارت‌های گرافیک قدرتمند و گران‌قیمت محدود نیست. با پیشرفت پردازنده‌های گرافیکی مجتمع و افزایش حافظه قابل‌استفاده برای هوش مصنوعی، حتی بعضی از رایانه‌های کوچک و پردازنده‌های قدیمی‌تر نیز می‌توانند مدل‌های زبانی را بدون وابستگی دائمی به سرویس‌های ابری اجرا کنند. البته سرعت تولید پاسخ، میزان مصرف انرژی و اندازه مدلی که می‌توان اجرا کرد، به سخت‌افزار و نرم‌افزار مورد استفاده بستگی دارد.

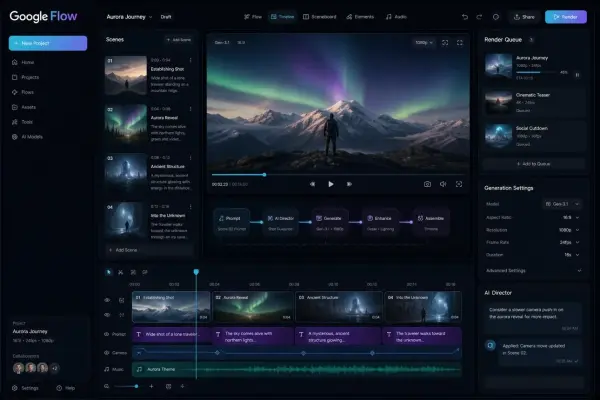
رفع خطای Google Flow؛ راهنمای بررسی کشور حساب گوگل و مشکل دسترسی

خطای «Flow is not available in your country yet» در ابزار هوش مصنوعی Google Flow به این معناست که سرویس، کشور یا منطقه فعلی کاربر را برای دسترسی مجاز تشخیص نمی‌دهد. این پیام لزوماً به معنی خرابی مرورگر یا اینترنت نیست؛ زیرا دسترسی ممکن است به محل پشتیبانی‌شده، وضعیت حساب گوگل و محدودیت‌های منطقه‌ای سرویس وابسته باشد.

تغییر آدرس IP به‌تنهایی دسترسی را تضمین نمی‌کند. همچنین باید توجه داشت که ارسال درخواست تغییر کشور حساب گوگل لزوماً به پذیرش درخواست یا فعال‌شدن Google Flow منجر نمی‌شود.

اجرای مدل‌های هوش مصنوعی بزرگ روی کارت گرافیک ضعیف با معماری MoE

اجرای مدل‌های زبانی بزرگ (LLM) روی کامپیوتر شخصی، بدون ارسال اطلاعات به سرویس‌های آنلاین، به یکی از کاربردهای جذاب هوش مصنوعی محلی تبدیل شده است. با این حال، اجرای مدل‌های بزرگ روی کارت گرافیک‌های قدیمی یا اقتصادی همیشه ساده نیست؛ زیرا حافظه گرافیکی محدود می‌تواند اندازه مدل قابل اجرا و سرعت تولید پاسخ را محدود کند.

یکی از راهکارهای کاربردی برای عبور از این محدودیت، استفاده از معماری Mixture of Experts یا MoE است. این معماری به مدل اجازه می‌دهد برای پردازش هر ورودی فقط از بخشی از شبکه استفاده کند. در نتیجه، بعضی مدل‌های MoE با وجود داشتن تعداد پارامترهای بسیار زیاد، می‌توانند روی سیستم‌هایی با حافظه گرافیکی محدود نیز قابل اجرا باشند؛ البته سرعت نهایی به مدل، میزان فشرده‌سازی، حافظه رم و تنظیمات نرم‌افزار بستگی دارد.

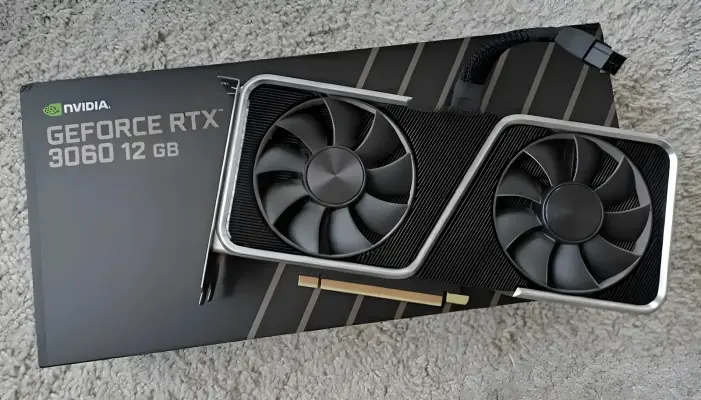
چرا کارت گرافیک RTX 3060 با حافظه ۱۲ گیگابایتی دوباره ارزشمند شده است؟

کارت گرافیک RTX 3060 با حافظه ۱۲ گیگابایتی در زمان عرضه در سال ۲۰۲۱، یکی از گزینه‌های مناسب برای گیمرهایی بود که به دنبال سخت‌افزاری مقرون‌به‌صرفه بودند. این کارت هرگز سریع‌ترین عضو خانواده Ampere نبود و عملکرد آن در رهگیری پرتو نیز چندان چشمگیر به نظر نمی‌رسید؛ اما چند سال بعد، شرایط بازار سخت‌افزار تغییر کرده و همین مدل قدیمی دوباره اهمیت پیدا کرده است.

نکته جالب این است که سخت‌افزار اصلی RTX 3060 تغییر نکرده، اما نیازهای جدید بازار باعث شده‌اند حافظه گرافیکی ۱۲ گیگابایتی آن ارزش بیشتری پیدا کند. کمبود حافظه در بازار کارت‌های گرافیک و افزایش تقاضا برای اجرای مدل‌های هوش مصنوعی به‌صورت محلی، از عواملی هستند که جایگاه این کارت را تغییر داده‌اند.

دانلود و معرفی Voicebox؛ شبیه‌سازی صدا با هوش مصنوعی

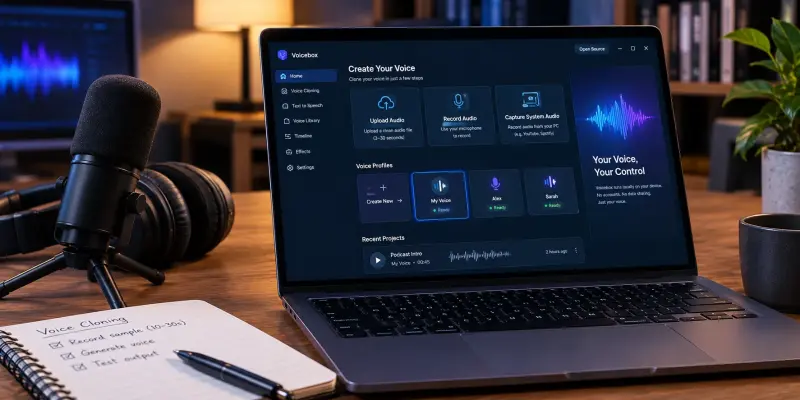
Voicebox یک ابزار رایگان و متن‌باز برای شبیه‌سازی صدا با هوش مصنوعی است که امکان ساخت صدایی شبیه نمونه صوتی ورودی و تبدیل متن به گفتار را فراهم می‌کند. این برنامه برای ویندوز، لینوکس و مک‌او‌اس طراحی شده و می‌تواند برای تولید پادکست، کتاب صوتی، دیالوگ شخصیت‌های بازی و قابلیت‌های دسترس‌پذیری کاربرد داشته باشد.

نکته مهم این است که شبیه‌سازی صدا فقط یک قابلیت سرگرم‌کننده نیست؛ اگر صدای فردی بدون اجازه او بازسازی شود، امکان سوءاستفاده در تماس‌های تلفنی، جعل هویت و کلاهبرداری نیز وجود دارد.

Mistral Large 4؛ بررسی مشخصات و بنچمارک مدل هوش مصنوعی یک تریلیون پارامتری

Mistral Large 4 یکی از مهم‌ترین مدل‌های هوش مصنوعی معرفی‌شده در سال ۲۰۲۶ است که با هدف نزدیک کردن مدل‌های دارای وزن باز به مدل‌های قدرتمند تجاری عرضه شده است. این مدل که با نام غیررسمی Le Chonk نیز شناخته می‌شود، در حال حاضر به صورت پیش‌نمایش عمومی در اختیار کاربران و توسعه‌دهندگان قرار گرفته و قرار است وزن‌های آن نیز در ادامه ماه منتشر شود.

نکته مهم این است که Mistral Large 4 هنوز با یک مدل کاملاً آماده برای اجرای محلی فاصله دارد. نسخه فعلی بیشتر برای آزمایش از طریق API طراحی شده است و تا زمانی که وزن‌های نهایی منتشر نشوند، امکان اجرای کامل مدل روی سخت‌افزار شخصی وجود ندارد. به همین دلیل، برای بیشتر کاربران عادی فعلاً نباید آن را جایگزین مستقیم ChatGPT یا سایر دستیارهای هوش مصنوعی دانست.

آخرین دیدگاه‌ها
۲۰۰ دیدگاه و پاسخ آخر